九月 16, 2026
摘要:在本教程中,您将学习 PostgreSQL 同步复制的核心机制、主要的误区与真相。
目录
核心背景与基础概念
1. WAL 预写日志
WAL 是 PostgreSQL 保障数据完整性的核心,数据库的恢复、归档和复制功能均基于 WAL 实现。WAL 文件通常以十六进制命名,默认大小为 16MB。
2. 物理流复制的机制
- 主库 (Primary):负责生成 WAL 文件。当备库连接时,主库会启动
wal sender进程,将 WAL 日志流式传输给备库。 - 备库 (Standby):通过
wal receiver进程接收 WAL 并落盘保存。随后,备库上的startup process(启动进程)会读取并应用这些事务变更,从而与主库保持数据一致。
3. 流复制的两种模式对比
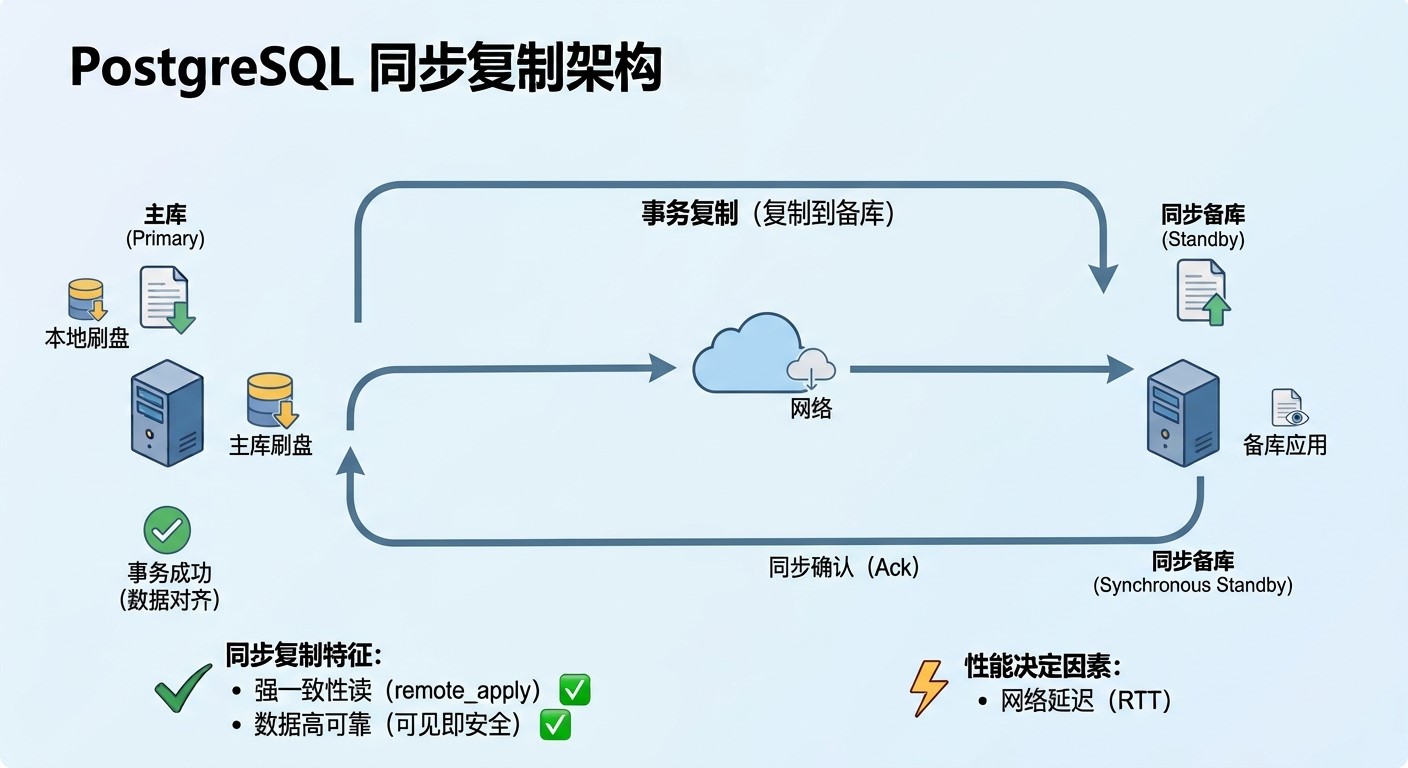
- 异步复制:主库将事务写入 WAL 并刷盘后,立即向应用端返回成功,不等待备库确认接收。
- 同步复制:主库必须等待同步备库返回确认信号(已接收/已刷盘/或已应用事务)后,才会通知应用端事务执行成功。
同步复制的关键配置参数
1. synchronous_commit (同步提交级别)
该参数在主库上配置,决定了主库等待备库确认的严格程度:
- on (默认值):保证事务在主库本地持久化,且已复制到备库并持久化(能抵御服务器崩溃)。
- remote_apply:最严格级别。保证事务不仅到达备库,且已被备库应用,对备库的客户端查询可见。
- remote_write:仅等待备库回复“已写入操作系统缓存”(不保证已物理落盘)。
- local:可针对单条连接开启,事务仅在主库本地提交,不等待任何备库响应。
2. synchronous_standby_names (同步备库策略)
定义了多个备库时的确认规则:
- 优先级复制 (Priority):语法如
FIRST n (node1, node2)。主库严格按列表顺序等待前 n 个节点确认。缺点:若首选节点宕机,主库需耗时察觉并切换至下一节点。 - 仲裁复制 (Quorum, PG 10 引入):语法如
ANY n (node1, node2)。主库等待列表中任意 n 个最快响应的节点确认。效率更高,但不保证事务具体保存在哪几个节点。
同步复制的 5 大核心误区与真相
误区一:事务只有在备库确认后,才会在主库本地提交
✅ 真相:事务总是先在主库本地完成提交 (Committed Locally)。
原理解析:应用发送 COMMIT 后,主库会先在本地写入并提交事务,但此时主库会持有锁,事务对客户端处于不可见状态。只有当足够的备库发回确认后,主库才会释放锁,使数据可见,并通知应用程序成功。
例外隐患:如果等待期间查询被意外中断(如 TCP 连接断开、主动 Ctrl+C 或数据库重启),主库的等待将被取消,此时本地已提交的事务会直接变为可见,尽管它并未成功复制到备库。
误区二:同步复制能保证主备切换时“零数据丢失”(RPO=0)
✅ 真相:视情况而定,在特定场景下仍可能发生“可见数据丢失”。
潜在风险:如误区一所述,若应用主动断开连接,某笔事务在主库上已处于可见状态。若此时主库彻底宕机,集群触发 Failover(故障转移)将同步备库提升为新主库,这部分仅存于原主库的可见数据就会丢失。
解决方案:应用层可使用两阶段提交(2PC);或在重连后使用 txid_status() 函数来确认断连期间某笔事务的最终状态(已提交/已中止/进行中)。
误区三:在同步备库上读取数据,等同于在主库上读取
✅ 真相:备库数据可能比主库更早可见。
原理解析:在 remote_apply 模式下,同步备库一旦应用了事务,便立即对其本地客户端可见。但此时,主库可能还在等待其他仲裁节点返回确认(处于锁定阻塞状态),导致在主库上反而查不到这笔最新数据。
最佳实践:绝对不要基于备库的读取结果,去指导主库上的写操作。(若需 100% 强一致性读,需将集群配为全同步,或在应用层依靠 WAL LSN 序列号核对同步进度)。
误区四:既然用了同步复制,就不再需要 pg_rewind 工具了
✅ 真相:即使是同步复制架构,主备切换后依然需要 pg_rewind。
原理解析:主库的 WAL 日志生成独立于备库。例如,VACUUM(空间清理)等后台操作会产生 WAL。在主库崩溃前,它可能比备库多写了一点点底层数据页的 WAL。当旧主库要重新加入集群作为新备库时,必须使用 pg_rewind 对齐时间线。此外,环境中的“异步备库”进度可能比被提升的“同步备库”还快,同样需要回卷修复。
误区五:同步复制会导致数据库性能极其缓慢
✅ 真相:不完全对,性能损耗主要取决于“硬件”与“网络物理延迟 (RTT)”。
性能耗时拆解:单笔事务总延迟 ≈ 主库磁盘延迟 + 备库磁盘延迟 + 节点间网络往返延迟 (RTT)。
实测数据:
- 在低延迟网络下(如 5ms),异步变同步会导致单次事务延迟增加数毫秒,TPS(每秒事务数)下降约一半,但可通过增加连接并发数来弥补。
- 但若网络延迟极高(如调至 100ms),单笔事务延迟会直接飙升至 100ms 以上,TPS 出现断崖式下跌。
实践建议:永远不要跨大洲(远距离)部署同步复制节点,物理网络延迟将直接锁死业务性能上限。
参考
Myths and Truths about Synchronous Replication in PostgreSQL