由 John Doe 十月 22, 2026
同样的数据库、同样的硬件,只升级了内核,吞吐量却直接砍半。本文带你厘清问题的真正原因。
目录
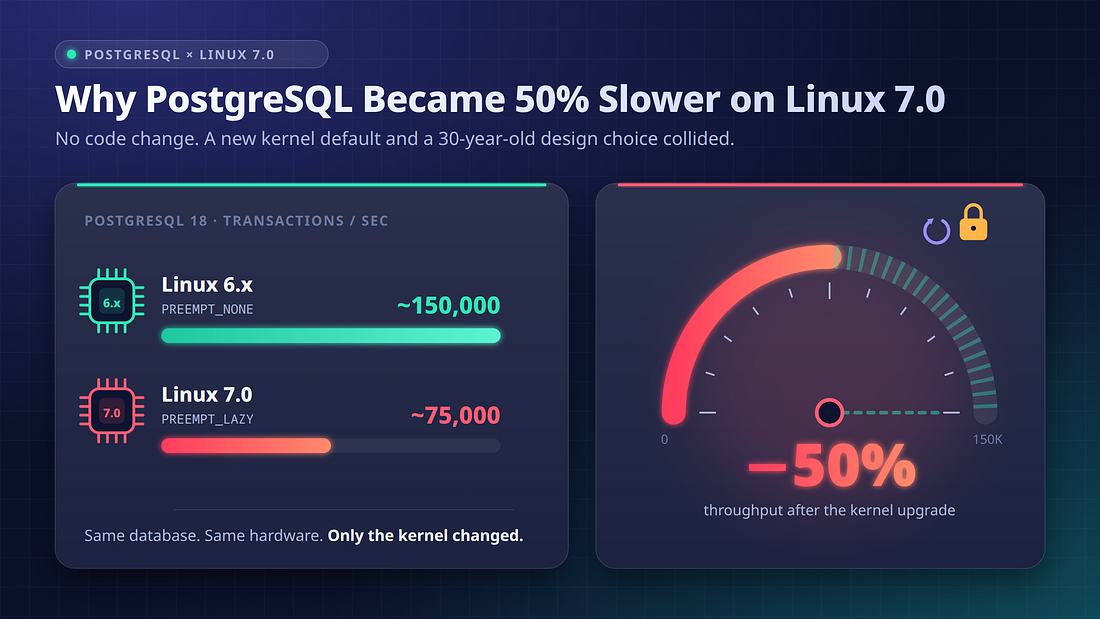
想象一下:你只升级了操作系统,数据库和应用代码一行都没动,结果第二天数据库能承载的流量就只剩昨天的一半。
这就是 PostgreSQL 在 Linux 7.0 上遭遇的真实问题。周末我翻阅了一些优质的工程技术文章,偶然发现了这个案例。这是我见过最能体现「底层系统层级如何出人意料」的真实案例之一,因此我会用通俗的语言把它整理出来,并从零开始讲解涉及的每一个操作系统概念。
问题是如何被发现的
亚马逊运营着托管式 Postgres 服务(RDS 和 Aurora),其内部团队会针对每一个新版 Linux 内核进行测试,验证 Postgres 的性能升降。
2026 年 4 月,工程师萨尔瓦托雷(Salvatore)发现了性能下滑。相同的 Postgres 版本、相同的硬件配置,唯一变量只有内核,因此问题根源必然出在内核当中。
他没有止步于「性能变慢了」这个结论,而是通过二分法定位:重新编译内核、运行基准测试,逐次缩小提交范围,最终精准定位到了引发问题的那一处代码变更。
「变慢了」只是抱怨,「是这次提交导致了性能下降」才是真正的发现。
Postgres 如何处理连接
Postgres 会启动一个名为 postmaster 的主进程,监听 5432 端口。每接入一个新客户端,它就会创建一个全新的操作系统进程,称为后端进程。也就是说,1000 个连接就对应 1000 个独立的进程。
MySQL 和 SQL Server 的实现方式则不同:一个连接对应一个线程,所有线程都运行在同一个进程内。请记住这个架构差异,它是整个问题的核心。
所有后端进程都需要访问同一份数据,因此 Postgres 会维护一块大型共享内存区域,叫做 共享缓冲区(shared buffers),这是 Postgres 自身的表页与索引页缓存。所有后端进程都会对其进行读写,而这次的问题恰恰就出在这里。
互斥锁 vs 自旋锁
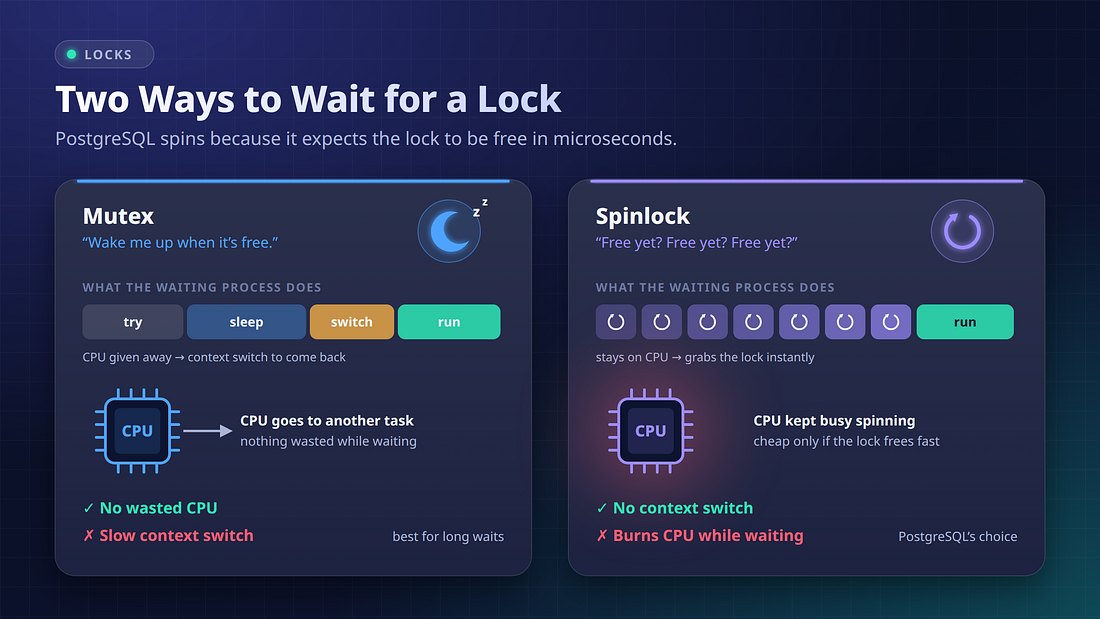
当多个进程共享内存时,不能同时修改同一份数据,否则会造成数据损坏,因此需要用到锁。常见的锁等待机制有两种。
互斥锁(mutex):如果锁已被占用,当前进程会进入睡眠状态,之后由操作系统唤醒。听起来很「礼貌」,但睡眠并非没有代价,你的 CPU 时间会让给其他进程,重新拿回 CPU 需要发生上下文切换。如果你只需要占用锁几微秒,睡眠 + 唤醒的开销甚至会超过实际工作本身。
自旋锁(spinlock):不会进入睡眠,而是一直占用 CPU 循环检查:锁释放了吗?释放了吗?一旦锁被释放,立刻就能获取,全程没有上下文切换。代价是自旋期间会持续浪费 CPU 资源。
Postgres 在共享缓冲区内部的轻量快速操作中使用自旋锁,比如选取一个空闲页。它的使用也很谨慎:每次获取失败后都会逐步延长退让间隔(指数退避),避免无限自旋。
所有自旋锁的使用都基于一个前提:锁的持有时间极短,因此自旋的成本很低。而 Linux 7.0 打破了这个前提。
什么是抢占
抢占指的是内核强制将进程从 CPU 上换下,让其他进程获得运行机会。这是正常机制,没有抢占的话,一个繁忙的程序就能卡死整台机器。
关键细节在于,进程运行分为两种模式:
- 用户态(ring 3):运行普通业务代码
- 内核态(ring 0):内核代进程执行操作,比如处理系统调用、缺页异常
长期以来,大多数 Linux 服务器都运行在PREEMPT_NONE模式下:进程一旦进入内核代码执行,就会让它运行完再切换。这是 Linux 6.x 系列一贯的默认配置。
Linux 7.0 将默认配置切换为了PREEMPT_LAZY,意味着内核代码执行过程中也可以被抢占。初衷很合理:当有其他任务紧急需要 CPU 时,内核不该一直占用资源。这是一项明智的改动,也不会被回退,上层软件需要去适配它。
页表、缺页异常与 TLB
每个进程都认为自己拥有独立、干净的私有内存,这就是虚拟内存。操作系统通过页表,将每个虚拟地址映射到真实的物理内存上。
每个进程都有独立的页表;同一进程内的所有线程共享同一张页表。
Linux 默认以 4KB 为单位进行内存分页,并且采用惰性分配机制:不会提前填好页表。当进程第一次访问某个地址时,还没有对应的地址映射,CPU 就会触发缺页异常(page fault)。进程会陷入内核态,由内核建立地址映射,之后进程再继续运行。
因此,处理缺页异常需要执行内核代码,而在 Linux 7.0 上,内核代码是可以被抢占的。
CPU 还会在一块容量很小、速度极快的缓冲区中缓存最近的地址映射,这块缓冲区叫做转译后备缓冲区(TLB, Translation Lookaside Buffer)。TLB 命中几乎没有开销;一旦未命中,CPU 就会遍历页表,如果页表中也没有对应条目,就会触发缺页异常。
真正的问题成因
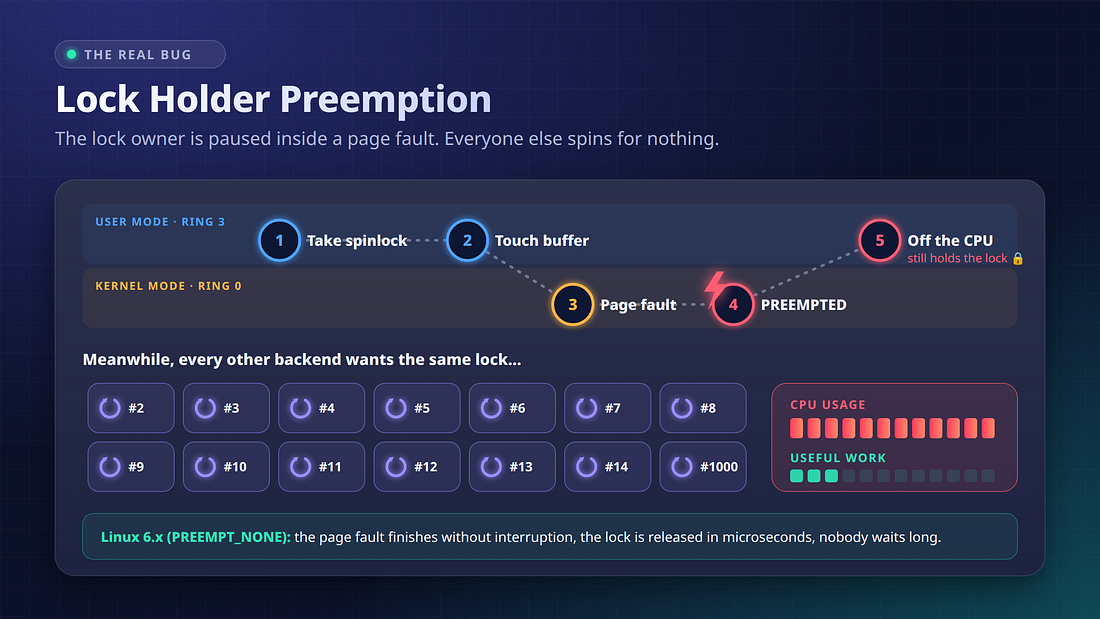
把所有线索拼起来,整个故障链路是这样的:
- 一个后端进程需要从共享缓冲区中获取一个空闲页。
- 它获取了自旋锁。
- 它访问了一个从未触碰过的共享内存地址。
- 触发缺页异常,进程进入内核态。
- Linux 7.0 在处理缺页异常的过程中,将该进程抢占换下。
- 进程已经离开了 CPU,但它依然持有那把自旋锁。
- 上百个其他后端进程都在等待这把锁,全部进入自旋状态。
锁的持有者重新获得 CPU 运行时间之前,锁永远不会被释放。CPU 看起来占用率很高,但实际完成的有效工作极少。
在 Linux 6.x 上,缺页异常也会频繁发生,但每一次都会无中断地执行完成,锁只会被持有极短时间,自旋锁的前提依然成立。Linux 7.0 让一把本该只持有几微秒的锁,可能被一个根本不在运行的进程长期持有。
这是一个已知的经典问题,叫做 锁持有者抢占(lock holder preemption),在虚拟机场景中也会出现。
为什么「一连接一进程」让问题雪上加霜
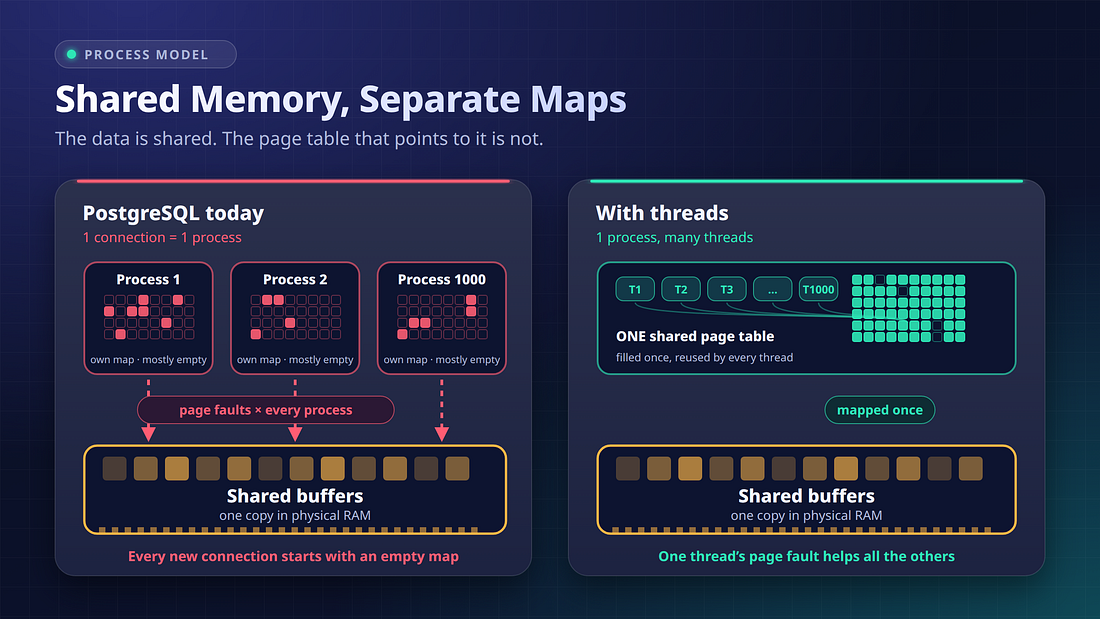
你可能会想:页面一旦被加载映射完成,就会一直存在,等内存都「预热」完之后,问题就会消失。对于线程模型来说确实如此,但对进程模型来说不是。
在线程模型下,1000 个线程共享同一张页表。一个线程触发一次缺页异常,其他所有线程都能直接复用这个映射。
而在进程模型下,每个后端进程启动时都有自己的空白页表,访问同一块共享缓冲区时,每个进程都要各自触发一次缺页异常。物理内存里的数据只有一份,但地址映射不是,每个进程都要建立自己的映射。
我们可以算一笔账:一台配置 400GB 共享缓冲区的大型服务器,使用 4KB 页面的话,需要约 1 亿个页表项,而且这是单进程的量级。再乘以 1000 个连接,数量极其庞大。每一次缺页异常都要进入内核态,每一次进入内核态,都多了一次「锁持有者在最差时机被抢占」的可能。
总结下来,四个因素共同作用:
- Linux 7.0 允许内核代码被抢占。
- Postgres 使用的自旋锁,默认假设锁持有时间极短。
- Postgres 采用进程模型,每个连接都要独立触发缺页异常。
- 4KB 的小页面导致页表项数量极其庞大。
单独看每一项都不是 bug,但叠加在一起,就让吞吐量直接砍半。
解决方案 1:大页(huge pages)
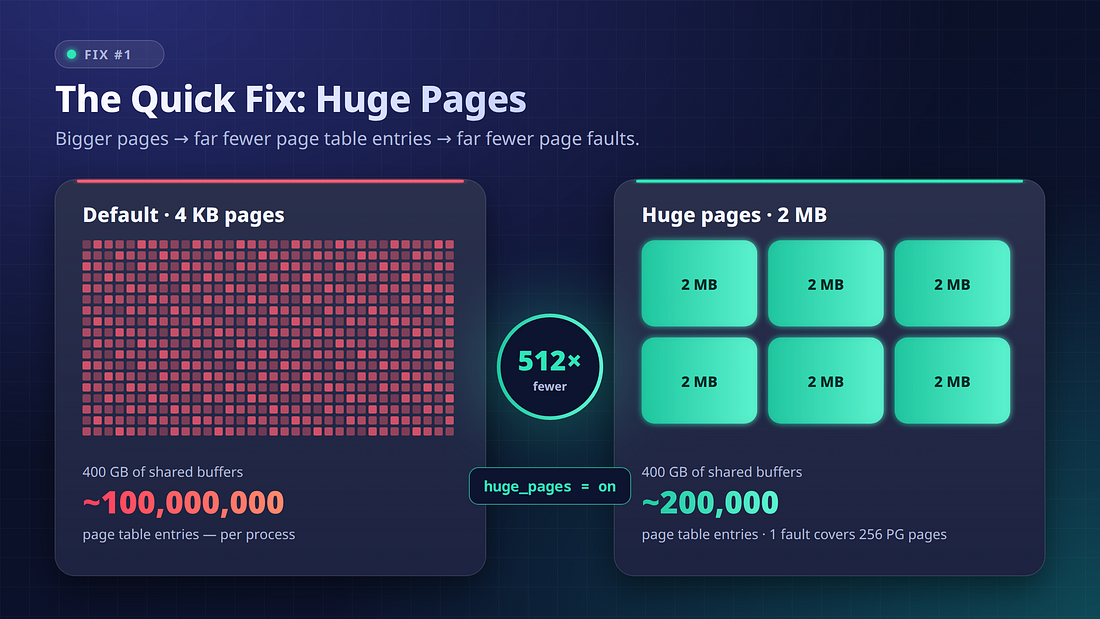
知名 Postgres 开发者安德雷斯・弗罗因德(Andres Freund)在讨论中直白地表示:如果你的共享缓冲区有几百 GB,就不该还用 4KB 页面,开启大页吧。
大页的大小为 2MB,是 4KB 的 512 倍。同样 400GB 的内存,只需要约 20 万个页表项,而非 1 亿个。缺页异常的次数减少 512 倍,发生恶性抢占的概率也随之降低 512 倍。
Postgres 自身以 8KB 为单位存储数据页。使用 4KB 操作系统页面时,一个 Postgres 页可能需要触发两次缺页异常;而使用 2MB 大页时,一次缺页异常就能覆盖 256 个 Postgres 页。
萨尔瓦托雷开启大页后,性能回退现象直接消失了。
开启方式:在postgresql.conf中设置huge_pages = on,同时在操作系统中通过vm.nr_hugepages参数预留大页内存。
解决方案 2:让内核不要中途打断
Linux 有一项名为 可重启序列(rseq, restartable sequences) 的特性,其扩展功能叫做 rseq 分片扩展。它允许程序向内核发出提示:「我正处于临界区、持有锁,此刻请不要抢占我。」
这只是提示,不是强制保证。如果临界区执行时间过长,进程依然会被抢占。但它能大幅降低恶性抢占的概率,逻辑也很简单:暂停一个锁持有者,会导致上百个其他进程空转自旋,纯属浪费。
有人向 Postgres 开发者提出了这个方案,但安德雷斯・弗罗因德认为不值得为此新增代码。
解决方案 3:从进程模型转向线程模型
这是长远方向的思路。如果改用线程模型,所有线程共享同一张页表,一次缺页异常就能惠及所有线程,从而减少缺页次数、提升 TLB 利用率、降低页表占用的内存、降低连接创建成本。
社区对此已经讨论了很多年,但这是一项极其庞大的改动。大量 Postgres 代码依赖全局变量,每个进程都有独立副本,全部都要改造;很多扩展也会因此失效。此外,故障隔离能力会被削弱:如今单个后端进程崩溃不会影响其他连接,但换成线程模型后,一次严重崩溃可能导致整台服务器宕机。
因此这项改动至今没有落地。这次 Linux 7.0 的事件,只是又为「改用线程模型」的论点增加了一个论据。
我的收获与思考
每个系统的运行都建立在一系列假设之上。Postgres 的自旋锁假设锁持有时间很短,这个假设在过去二十多年里一直成立。一次内核默认配置的变更,就让性能直接腰斩。我们也值得把自己代码里的隐性假设梳理出来,并实际去验证它们。
底层的层级总会带来意外。对 Postgres 来说,读取共享内存看起来成本很低,但底层之下还有页表、TLB、缺页异常和调度器在运作。
两个正确的决策,叠加后可能产生糟糕的结果。Linux 的改动能提升调度公平性,Postgres 的进程模型能保障故障隔离,两者单独看都没有错,但合在一起就造成了 50% 的性能下降。
定位问题要靠隔离排查,而非猜测。萨尔瓦托雷逐提交排查,最终让问题根源无处遁形。
总结
Postgres 变慢不是因为代码写得差,Linux 的改动也不是错误决策。性能下降的根源,是两个合理、沿用已久的设计选择碰撞在了一起。
如果你运行的 Postgres 配置了大容量共享缓冲区,请开启大页。对其他人来说,这也是一个很好的提醒:要理解你软件之下的每一层系统。大多数时候它们都静默运行,但一旦其中某一层发生变化,问题的根源可能和表象相距甚远。