由 John Doe 十月 21, 2026
多年来,开发者始终将 PostgreSQL 定位为应用的数据存储载体:业务逻辑封装在应用程序中,Redis 负责缓存,Kafka 流转事件,后台工作进程处理任务,搜索、调度类功能则由独立服务实现。 PostgreSQL 居于整个架构的底层,默默承担着本职工作。
目录
而这套架构,正在悄然发生变化。
现代 PostgreSQL 所能承载的能力,远不止存储数据行和执行查询。凭借扩展插件、内置并发控制、高级索引、逻辑复制,以及 LISTEN/NOTIFY 等特性,它可以承担过去需要多个独立基础设施组件才能完成的工作。
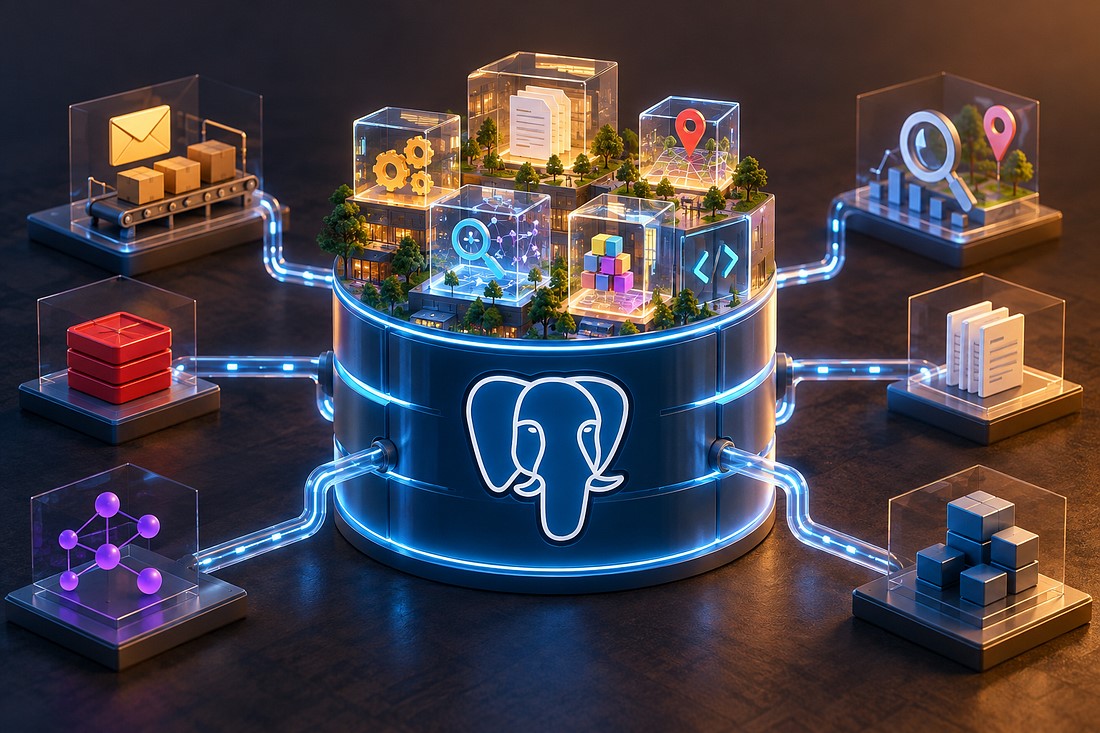
值得关注的核心不是 PostgreSQL 变成了一款更优秀的数据库,而是开发者正开始将它作为 应用开发平台 来使用。 这也将彻底改变我们设计后端系统的思路。
数据库不再仅仅是数据库
试想一个典型的后端应用: 你可能会部署一套 Java 或 Go 服务,用 PostgreSQL 做持久化存储,Redis 做缓存,Kafka 做消息队列,再搭配独立的 Worker 处理异步任务。每个组件都解决了实际问题,但每新增一个组件,都会带来额外的运维开销。
你的架构大概会呈现这样的形态:
             ┌─────────────────┐
             │     应用服务层  │
             └────────┬────────┘
                      │
          ┌───────────┼───────────┐
          │           │           │
          ▼           ▼           ▼
     PostgreSQL     Redis       Kafka
          │                       │
          │                       ▼
          │                  后台工作进程
          ▼
        数据存储
想想这背后需要多少协调工作:你需要管理连接、监控消费者延迟、处理重试逻辑、维护缓存一致性,还要排查跨多个系统的故障。
PostgreSQL 无法替代这套架构中的所有组件,但对于功能相对简单的场景,它完全可以省去部分中间件。 比如任务队列,并非永远都需要独立的消息平台;缓存也不一定非用 Redis 不可;事件驱动的工作流,也未必需要额外搭建服务。 很多时候,你已经在运维的数据库,就足以胜任这些工作。
1. PostgreSQL 可以充当你的任务队列
后台处理是最具实用性的落地场景之一。 应用经常需要发送邮件、生成报表、处理上传文件,或是执行定时任务。开发者通常会引入基于 Redis 的队列,或是专门的消息中间件来处理这类工作负载。
但 PostgreSQL 可以通过普通数据表、事务和行锁机制,实现可靠的任务队列。 来看这个简化的表结构:
CREATE TABLE jobs (
    id BIGSERIAL PRIMARY KEY,
    payload JSONB NOT NULL,
    status TEXT NOT NULL DEFAULT 'pending',
    created_at TIMESTAMPTZ NOT NULL DEFAULT NOW()
);
工作进程可以使用 FOR UPDATE SKIP LOCKED 语法认领任务,避免多个进程争抢同一条记录:
WITH next_job AS (
    SELECT id
    FROM jobs
    WHERE status = 'pending'
    ORDER BY created_at
    FOR UPDATE SKIP LOCKED
    LIMIT 1
)
UPDATE jobs SET status = 'processing'
WHERE id = (SELECT id FROM next_job)
RETURNING *;
核心细节在于:查询和更新在同一条语句内完成,且必须在事务中执行。PostgreSQL 的行锁机制允许多个工作进程同时认领不同的任务。 你无需额外引入其他数据库,就能添加重试次数、失败信息、调度时间戳,以及死信处理等功能。
当然,这种方案依然需要严谨的事务管理、进程恢复机制和监控手段,也无法自动提供专业队列平台的吞吐量和投递保证。 但对于绝大多数内部工作流来说,这是一个投入极低、效果出色的起步方案。
2. JSONB 让 PostgreSQL 的灵活性远超想象
针对 PostgreSQL 最古老的质疑之一,就是 “关系型数据库太僵化,无法适应快速变化的应用需求”。 但只要了解 JSONB 的能力,这个说法就站不住脚了。
假设你正在搭建一个交易平台:所有商品都有价格、位置、卖家这类通用字段,但不同品类需要不同的属性 —— 公寓有卧室数、卫生间数;汽车有里程数、燃油类型。 你可以为每个品类单独建表,或是把整个数据模型迁移到文档数据库。
换个思路:PostgreSQL 允许你将关系型结构与灵活属性结合起来。
CREATE TABLE listings (
    id BIGSERIAL PRIMARY KEY,
    title TEXT NOT NULL,
    price NUMERIC NOT NULL,
    attributes JSONB NOT NULL DEFAULT '{}'
);
这样一来,商品既可以承载品类专属信息,又能与关系模型中的其他数据保持完整的事务一致性。 你可以直接对 JSONB 字段执行查询,还可以为高频访问的属性建立索引,这意味着灵活性并不一定以牺牲查询能力为代价。
核心在于找准灵活性的适用场景:需要强约束、频繁关联、关系稳定的字段,适合用标准的关系型列和表存储;而当数据本身具备高度可变性时,JSONB 才是最优选择。 PostgreSQL 在一套系统里,同时给了你两种选项。
3. 事件驱动未必需要 Kafka
事件驱动架构确实实用,但开发者有时在确认工作负载是否真的需要之前,就贸然引入了 Kafka。 PostgreSQL 通过 LISTEN 和 NOTIFY 命令,提供了另一种轻量实现路径。
事务可以发布通知,所有监听对应通道的连接会话都能收到消息。通知会在事务提交后才投递,因此很适合用来协调轻量级的应用工作流。 举个例子:服务可以通知工作进程 “有新任务待处理”,而不用让它们持续轮询数据表。
但要注意:通知机制不等同于持久化消息队列。断开连接的监听器会错过消息,它也无法替代持久化事件日志和消费者偏移量管理。 更稳妥的设计是:将事件存储在数据表中,仅用通知作为 “有新记录” 的触发信号。
 应用服务
    │
    ▼
PostgreSQL 事务
    ├── 更新业务数据
    ├── 插入事件记录
    └── 发送通知
          │
          ▼
      工作进程
          │
          ▼
    读取待处理事件
这种模式既可以减少不必要的轮询开销,又能将唯一可信数据源保留在 PostgreSQL 内部。
当你需要可持久化的消息回放、高吞吐量的事件分发,或是独立的消费者组时,Kafka 依然是更优选择。重点在于:引入它是因为你的需求确实需要,而不是因为每张后端架构图里都有它。
4. 扩展插件让 PostgreSQL 拥有无限可能
当你了解扩展插件的能力后,就会发现这个 “平台” 的真正潜力远不止于此。
- PostGIS 提供了专业的地理空间处理能力
- pgvector 实现了向量相似度搜索
- TimescaleDB 为 PostgreSQL 扩展了时序数据处理能力
- PostgreSQL 内置的全文搜索,甚至可以满足多数搜索需求,无需单独部署搜索引擎
每一项能力,都拓宽了基于同一底层系统可构建的应用范围。
想象一个房产交易平台:它需要事务化的房源管理、地理范围搜索、灵活属性扩展,还有语义相似度搜索。 你不必下意识地引入多款专用数据库,而是可以先评估 PostgreSQL 能支撑其中多少工作负载。 系统越少,意味着运维依赖越少、备份流程越简单、数据同步逻辑越少。
但这里有一个重要的权衡:扩展插件本身也会带来性能特性、兼容性约束和运维层面的考量。把所有工作负载都整合到一个数据库里,也可能造成资源争抢。 我们的目标不是把所有东西都塞进 PostgreSQL,而是不要再默认 “每新增一个需求,就要搭一套新的基础设施”。
隐藏的优势:架构简洁
分布式系统中成本最高的部分,往往不是算力,而是协调成本。 每新增一个系统,都会带来配置、部署、监控、故障处理和数据一致性的额外要求。一张架构图上看起来简单的服务,当每个依赖在故障场景下表现各不相同时,就会变得异常复杂。
PostgreSQL 之所以是极具吸引力的替代方案,是因为它的诸多能力都共享同一套事务基础。
        应用服务
           │
           ▼
       PostgreSQL
   ┌───────┼────────┐
   ▼       ▼        ▼
 数据    任务队列  事件处理
           │
           ▼
      索引与扩展插件
这种架构并非在所有场景下都更优。如果不同工作负载争抢 CPU、内存、磁盘带宽或连接资源,它就可能成为瓶颈;单数据库也意味着更大的共享故障域。 但即便如此,从更少的组件起步,能让团队在增加复杂度之前,更充分地了解自身真实的性能需求。
什么时候依然需要专用基础设施?
如果你需要超大规模的事件吞吐量,Kafka 或许必不可少;如果你的工作负载要求极速的分布式缓存,Redis 可能更合适;如果你需要复杂的搜索排序能力,Elasticsearch 或 OpenSearch 的运维成本或许物有所值。
PostgreSQL 不应该仅仅因为 “能近似实现某些功能”,就去替代这些专业系统。 相反,你可以问自己三个问题:
- PostgreSQL 能否满足该工作负载在正确性和性能上的要求?
- 整合工作负载后,能否在不造成不可接受的资源争抢的前提下简化运维?
- 达到怎样的量化指标时,才必须切换到专用系统?
比起盲目追随技术潮流,思考这些问题才能帮你做出更合理的架构决策。
更大的行业变革
PostgreSQL 正在超越 “存储层” 的定位,因为现代应用需要的不只是存储。它们需要可靠的协调机制、灵活的数据模型、后台处理能力、事件分发能力,以及越来越专业的查询能力。 而这些功能,大多已经存在于 PostgreSQL 生态之中。
下次设计后端架构时,别急着先画上 Redis、Kafka 和另外三个服务再去分析问题。从满足需求的最简架构开始,实测它的性能边界,有充分证据支撑时,再引入专用基础设施。
后端工程的未来,或许不是给每个系统叠加更多组件。 而是去发现:我们已有的系统,本就能消解多少不必要的复杂度。
参考
PostgreSQL Is Becoming an Application Platform. Most Developers Haven’t Noticed