由 John Doe 九月 21, 2026
在热门表上添加索引来解决问题看起来很合理,但索引积累起来后可能很快就会增加成本。
目录
作者:Radim Marek
作为 “数据库专家”,我总会收到各种各样的问题,而过去八个月里,这些问题发生了明显变化。那些重复的基础问题消失了,没人再问 “怎么才能不把数据放进数据库”,提交评审的代码也明显更规范。但今年夏天,我收到一份数据库 schema 设计,单表就建议删掉十二个索引。从那时起我就开始怀疑,代码生成 Agent 存在过度建索引的问题。我看的下一份 schema,也是同样的情况。
把这简单归为 “AI 粗制滥造” 未免太轻率了,因为这些改动大多都很合理。所以我搭建了一套测试框架,实际测了测。
我将 30 份由模型生成的 schema 导入 PostgreSQL,审计了其中 12 份里的 838 个索引。结果模型的专业程度出乎我意料:我只找到 10 个完全没有对应需求的索引,其余的设计都很扎实。四款模型都能正确使用 GIN 和 GiST 索引,构建的部分索引谓词合理,多租户复合索引的列顺序也没问题。如今 AI 生成 SQL 的基线质量,比一年前要好得多。
额外索引的代价
索引是个好东西,直到你把它们都堆到那张承担所有写入的热点表上。
对于写入很少的冷表,你根本感觉不到区别。但在热点表上,每多一个索引,每次写入就要多做一份工作。
在一个客服工具的 schema 里,模型仅在 tickets(工单)表上就建了 16 个索引。其中 6 个都索引了 last_activity_at 列,而每次客服处理工单时,这个列都会更新。和我手写的 7 个索引的基线方案相比,这份生成的 schema 产生的 WAL(预写日志)量是 1.8 倍,单次更新耗时是 1.9 倍,VACUUM(清理)的时间也同比增加。
这 16 个索引并非低级错误。对于读查询来说,它们跑得很快。问题在于,代码生成 Agent 是逐查询地建索引,完全不考虑写入流量。
当你更新一行数据时,磁盘上实际发生了什么:
- HOT 更新失效:只要有任何索引涉及被修改的列,Heap-Only Tuple(堆内元组)技术就彻底用不了了。PostgreSQL 无法在不更新索引指针的情况下,把新版本的行数据限制在原来的 8KB 数据页内。
- 表上所有
WHERE谓词匹配新元组的索引,都会写入一条新的索引条目,不只是你修改的列对应的那个索引。 - 每一次索引插入都会产生额外的 WAL 日志。
- 死元组清理:旧版本的行会留在堆表中,直到 VACUUM 清理掉它;而 VACUUM 必须遍历所有二级索引,剪掉指向旧行的指针。索引越多,VACUUM 扫描就越慢,哪怕只改了三行数据。
我一直没能把 VACUUM 的开销和 WAL 体量完全分开,两者总是相互影响。下文的 VACUUM 数据仅供参考趋势,不作为精确测量值。
实验设置
我为这次评审虚构了六个 SaaS 产品场景:
- 共享收件箱客服工具
- 健身房课程预约系统
- 产品分析工具
- 电商市场应用
- 兽医诊所管理系统
- 货运管理看板
其中一组运行结果来自 Andrey Grunev,这样我就不用再买一份订阅了。后来我想为那款模型获取更多数据,就自己又跑了一次。
测试中不提供表名、列名提示,也不指定数据库约束,只说明使用 PostgreSQL。同时,完全没提之后会有人统计索引数量。前四个需求文档是我自己写的(只用 LLM 润色了一下),后两个是由另一款独立模型根据我的简短需求描述生成的。六个需求里有一份比其他的更简略,输出结果也体现出了这一点。我保留了原样没有修改,回头去改的话,评审过程中产生的各种先入之见会污染测试结果。
每份需求都发给全新的模型实例,不提供 schema 模板,也不给索引提示,只要求:设计 PostgreSQL schema,编写 SQL 查询,不要提问。三家厂商的四款模型生成了这些 schema。为了把焦点放在数据库本身,而不是搞模型排行榜,我把它们命名为模型 A 到模型 D,不暴露厂商名称。
30 次运行里有 26 次,在提示词末尾多了一行:make it production-ready(做到生产级可用)。这是人们实际使用代码 Agent 时会输入的话,所以我保留了这句话;之后又单独去掉这句话,重新跑了模型 B 和 D 作为对照。
全部 30 次运行的结果都导入了 PostgreSQL 18.6。所有指标都来自运行中数据库的 pg_index 和 pg_stat_* 系统视图。Schema、需求文档、测试框架、原始 CSV 数据和预注册文件都放在了 Github 项目 vibe-coded-indexes。
索引都堆在同一张表上
从汇总数据上看,平均索引密度好像还不错。问题在于这些索引都集中在了哪里。
所有 Agent 都把索引堆到了写入最多的那张单表上:客服场景是 tickets 表,健身场景是 class_occurrence 表,货运场景是 loads 表。
| 应用 | 索引最多的表 | 生成的索引数 |
|---|---|---|
| 客服工具(7 次运行) | tickets |
10–16 |
| 健身系统(3 次运行) | class_occurrence |
6–10 |
| 分析工具(3 次运行) | events |
5–8 |
| 电商市场(7 次运行) | products |
8–11 |
| 兽医系统(6 次运行) | appointment(s) |
5–11 |
| 货运看板(4 次运行) | loads |
7–15 |
数量为近似值,有几次运行里存在重叠的部分索引,我不太确定该怎么计数。
每个应用的核心数据都存在这些表里。模型是逐功能地读取需求:每加一个过滤或排序规则,就多建一个索引,没有哪个 Agent 会检查已经存在的索引。有意思的是,没有模型会下意识地给外键建索引;甚至可以说,它们在外键上的索引建少了。部分索引、表达式索引、GIN、GiST、INCLUDE 列、带租户前缀的复合索引,语法上全都没问题。
单张表的情况如下。一共 15 个二级索引,第 16 个是主键:
| 索引名 | 索引列 | 仅包含满足以下条件的行 |
|---|---|---|
tickets_open_queue_idx |
workspace_id, last_activity_at | 状态为待处理类 |
tickets_open_by_status_idx |
workspace_id, status, last_activity_at | 状态为待处理类 |
tickets_open_by_assignee_idx |
workspace_id, assignee_id, last_activity_at | 状态为待处理类 |
tickets_open_by_team_idx |
workspace_id, team_id, last_activity_at | team_id 非空、状态为待处理类 |
tickets_unassigned_idx |
workspace_id, priority, last_activity_at | assignee_id 为空、状态为待处理类 |
tickets_org_idx |
workspace_id, organization_id, last_activity_at | organization_id 非空 |
tickets_first_response_due_idx |
workspace_id, first_response_due_at | 未回复、状态非已解决 / 已关闭 |
tickets_resolution_due_idx |
workspace_id, resolution_due_at | solved_at 为空、设置了截止时间 |
tickets_solved_idx |
workspace_id, solved_at | solved_at 非空 |
tickets_requester_idx |
workspace_id, requester_id, created_at | (全部行) |
tickets_created_idx |
workspace_id, created_at | (全部行) |
tickets_subject_trgm_idx |
subject | (全部行) |
tickets_subject_fts_idx |
workspace_id, subject_tsv | (全部行) |
tickets_number_key |
workspace_id, number | (全部行),唯一索引 |
tickets_tenant_key |
workspace_id, id | (全部行),唯一索引 |
每次回复、分配、关闭、重开工单时,status 和 last_activity_at 都会变化;有 9 个索引要么以这两列为键,要么在谓词里用到了它们,所以任何一次这类写入都会让 HOT 更新失效。关闭工单时,会向 tickets_solved_idx 插入一条新记录,同时在四个待处理队列的部分索引里留下死条目,等着 VACUUM 清理。
分析工具的 events 表也有差不多数量的索引,但几乎没有这些开销,因为那里的数据从不更新。对于只追加的表,索引几乎是 “免费” 的。
而且上面列表里的每个索引单独拿出来评审,都能通过。就像过去纯手写代码、人工评审时一样。问题出在所有东西加起来的总和。
十六个索引的开销
我在一张百万行的 tickets 表上跑了合成基准测试,模拟真实的客服工单操作:约 60% 是客户回复,25% 是状态更新,15% 是工单重新分配。测试基于 PostgreSQL 18.6,fillfactor 设为 90。为了保证行布局可预测,我关闭了自动清理(Autovacuum),通过 EXPLAIN (ANALYZE, BUFFERS, WAL) 采集 WAL 数据,结果取三次运行的平均值。
| 索引方案 | 二级索引数 | 测试前索引大小 | 产生的 WAL 量 | 更新耗时 | 测试后索引大小 | VACUUM 耗时 |
|---|---|---|---|---|---|---|
| hand 基线 | 7 | 176 MB | 436.0 MB | 4,850 ms | 230 MB | 264 ms |
| 客服场景 - 运行 3 | 9 | 173 MB | 426.2 MB | 4,377 ms | 227 MB | 236 ms |
| 客服场景 - 运行 2 | 15 | 221 MB | 647.8 MB | 8,599 ms | 324 MB | 394 ms |
| 客服场景 - 运行 1 | 15 | 259 MB | 776.8 MB | 9,013 ms | 361 MB | 436 ms |
所有测试都在我笔记本上的非特权容器中运行。多次重复测试的 WAL 体量很稳定(误差在 0.3 MB 以内),但执行时间波动最大可达 9%。1.8 倍和 1.9 倍这个相对倍率,是最稳定的结论。
注意运行 3:有 9 个索引,产生的 WAL 却比我 7 个索引的基线还略少,更新速度也更快。为什么?因为它用了严格的部分索引谓词:其中三个索引的 WHERE 条件非常严格,几乎不会匹配到任何被更新的行:
CREATE INDEX tickets_unassigned_urgent_idx
ON tickets (workspace_id, priority, created_at)
WHERE assignee_kind IS NULL
  AND status <> ALL (ARRAY['solved','closed']);
我手写的基线方案用了更宽泛的无条件索引,导致了更多的整页写入。换句话说,WAL 体量取决于索引的实际影响范围和页面脏污程度,而不是单纯的索引数量。
但即便如此,当模型建到 15 个索引时(运行 1 和运行 2),累积的开销还是很可观:同样 20 万次更新,WAL 是 1.8 倍,延迟翻倍,磁盘占用是 1.6 倍,VACUUM 时间多了 65%。
WAL 的影响不止于主库。所有写入的 WAL 都会通过网络同步到每个备库,还要进备份归档,所以额外的体量相当于要付出三倍成本。每次更新多 1.75 KB 听起来不多,但如果每秒 100 次更新,单表每天就会多出 15 GB 的 WAL。当然,我没法说你业务里最忙的表是不是刚好有这个流量,关键在于这个倍率。
跑运行 2 的时候,我花了半小时纳闷数据为什么突然飙升,最后才发现是 Docker Desktop 的内存限制拖慢了 PostgreSQL 的后台刷盘。重置限制后,波动就回到了正常水平。
这些索引确实有效
我测试了 9 条查询,客服场景运行 1 的方案在其中 4 条上快了 23 到 46 倍:按团队过滤从 0.76 ms 降到 0.02 ms,按组织过滤从 1.20 ms 降到 0.03 ms;与此同时,平均查询规划时间从 0.30 ms 升到了 0.44 ms。
9 条查询的完整结果(基于未舍入的平均值计算,百万行数据,对数刻度):
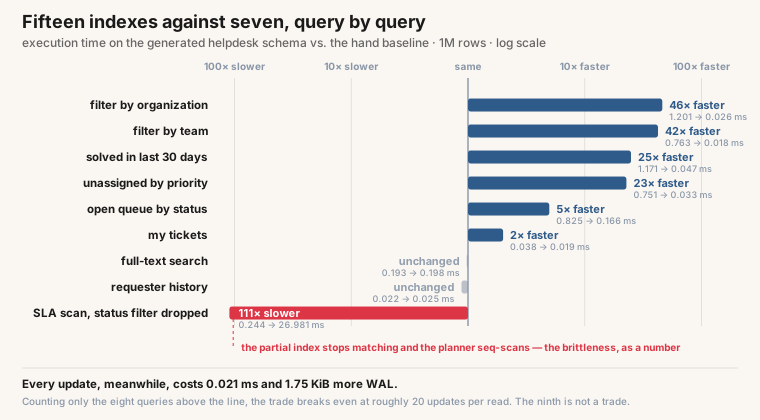
9 条查询里有 8 条表现符合预期。第九条是 SLA 巡检查询,在生成的 schema 上慢了 111 倍。为它准备的索引看起来没毛病:
CREATE INDEX tickets_first_response_due_idx
ON tickets (workspace_id, first_response_due_at)
WHERE first_response_at IS NULL
  AND first_response_due_at IS NOT NULL
  AND status <> ALL (ARRAY['solved','closed']);
如果查询单个工作区且满足所有条件,PostgreSQL 只需要读 8 个缓冲区。但去掉状态谓词的话,就完全用不了这个索引,得顺序扫描 43727 个缓冲区。
如果保留状态谓词,但要跨所有工作区巡检,这时候虽然还能用索引,但效果更差:要读 43699 个缓冲区,比直接全表扫描还慢。
我的基线方案里,first_response_due_at 上的索引没有带租户前缀,同样的巡检查询只需要 102 个缓冲区。SLA 巡检本质上是跨租户的,这张表其他地方都好用的 workspace_id 前缀,在这里反而成了累赘。
盈亏平衡点在哪里
去掉那条 SLA 查询,客服运行 1 的方案在其余 8 条查询上平均每次节省 0.554 ms。查询规划的开销会吃掉 0.146 ms,索引越多,优化器在执行未预编译的查询时要评估的选项就越多。最终净收益:每次读取节省 0.408 ms。
写入端的开销:(9013 − 4850) ms ÷ 200000 = 每次更新多花 0.021 ms。
把读的收益和写的开销对比,只要读写比低于 1:20(每 20 次更新对应 1 次读取),15 个索引的方案在 CPU 时间上就是划算的。而在客服应用里,客服会不断刷新队列,更新则是在刷新间隙批量到来,20:1 的比例并不是很难维持。单看 CPU 时间的话,这套方案完全说得过去。
但 CPU 不是全部成本。这个计算忽略了每天同步到备库和备份的 15 GB 额外 WAL。而且它假设流量模式是固定的。一旦上线一个批量更新 tickets 表的功能,这笔账就完全变了;但写入量变了之后,很少有人会回头重新评估 schema 上的索引。
索引建在哪一列上
16 个索引里有 6 个都把 last_activity_at 作为关键列,而索引建在什么列上,比索引数量本身代价更大。
我建了一张小表来测试:两边都是 6 个二级索引,对 30 万行执行同样的 UPDATE ... SET last_seen_at = now(),唯一的区别是,这 6 个索引里有没有一个建在被更新的列上。
| 被更新列的情况 | HOT 更新次数 | HOT 更新占比 | 更新耗时 |
|---|---|---|---|
| 未被索引 | 138,468 | 46.2% | 2,743 ms |
| 被索引 | 0 | 0.0% | 3,979 ms |
索引数量没变,工作负载也没变,只是一个索引的位置变了。把索引移到被更新的列上,就彻底失去了所有 HOT 更新,耗时增加了 45%。只有用合成表才能隔离出这个效应,保证其他所有条件都不变。
所以 (workspace_id, status, last_activity_at DESC) 这个索引值得再想想。它是个很合理的队列索引,换你手写也会这么建。但它也意味着,每次触碰工单都是一次非 HOT 更新,所有谓词匹配新行的索引(最多 16 个)都要插入一条新条目,还会留下一个死元组等着 VACUUM 清理。
我的基线方案也一样要检讨。对比测试的四套索引方案,HOT 占比都是 0%,包括我手写的 7 个索引。基于活动时间戳建队列索引太理所当然了,我自己也写了一个。不管哪种方案,HOT 更新都没了。区别只是生成的方案在每次写入时,还要多维护 8 个索引。
你可以在生产库上查一下当前情况:
SELECT
  s.relname,
  s.n_tup_upd,
  s.n_tup_hot_upd,
  round(100.0 * s.n_tup_hot_upd / NULLIF(s.n_tup_upd, 0), 1) AS hot_pct,
  (SELECT count(*) FROM pg_index i WHERE i.indrelid = s.relid) AS indexes
FROM pg_stat_user_tables s
WHERE s.n_tup_upd > 10000
ORDER BY hot_pct;
热点表的 hot_pct(HOT 更新占比)低,才是真正的信号:你得看看,哪个索引建在了你的 UPDATE 语句要碰的列上?
索引挤出了什么
一旦 HOT 更新失效,同样 20 万次更新里,每加一个二级索引,平均会多产生约 26 MB 的 WAL(基于 12 个索引的平均值)。这不是固定值:单个索引的开销从 18 到 46 MB 不等,取决于那次写入刚好触发了多少次整页镜像写入;而且从那以后,每次写入都要付出这个代价。
对缓存的影响更严重。上面的基准测试用了 shared_buffers=512MB,内存很充裕。当我把 shared_buffers 限制到 128MB 且冷缓存运行时,情况就反过来了:
| 索引方案 | 磁盘读取块数 | 缓存中的索引大小 | 缓存中的堆表大小 |
|---|---|---|---|
| 基线(7 个) | 53,089 | 92.6 MB | 35.2 MB |
| 客服运行 1(15 个) | 357,022 | 118.7 MB | 9.2 MB |
物理读取量飙升了 6.7 倍,缓冲区那一列说明了原因:额外的索引页总得占地方,它们挤出去的正是堆表数据。同样 128 MB 的缓冲池里,缓存的堆表数据从 35 MB 降到了 9 MB,而缓存的索引数据则相应增加;更新耗时的差距也从 1.9 倍扩大到了 2.1 倍。
在 512 MB 内存下完全不会有这个问题,因为所有数据都放得下。所以 128 MB 的测试只是演示效应,不是对你服务器的实际测量,它展示了当内存不够同时放下索引和堆表时,索引页会如何挤压缓存。
没人会删掉第十二个索引
问题的另一半在于下一次提交。
我把有 16 个索引的 tickets 表和一个普通的功能需求发给了 6 个全新的模型实例,两家厂商各 3 个,其中一家完全没参与之前的 30 次测试。需求是:按标签过滤工单列表,或者加一个 “等待客户回复” 的队列。提示词里既没提性能目标,也没提现有索引。
没有一次运行删掉了那第十二个索引。 6 次里有 5 次都加了新索引,而且无一例外都建在可变列上,搭配的也是可变谓词。
CREATE INDEX CONCURRENTLY tickets_waiting_on_customer_idx
  ON tickets (workspace_id, COALESCE(last_customer_message_at, created_at))
  WHERE status = 'pending';
来自不同厂商的两次运行,独立地写出了完全一样的索引,连 COALESCE 和谓词都分毫不差。
6 次运行都把标签放在了关联表里,而不是在 tickets 上加数组列,所以都没有加宽热点行。只有一个实例解释了这个选择:它拒绝用数组列,因为每次编辑标签都会破坏 HOT 更新;但转头它又加了一个 status = 'pending' 的部分索引,而这同样会破坏 HOT 更新。它发现了一个列的风险,却漏掉了另一个列的同样风险。
有一次运行基于现有索引创建了一个视图来满足需求,完全没加新索引,这才是正确答案。
我愿意相信自己评审时会接受那个视图方案。但说实话,要是提交里完全没有 schema 变更,我很可能扫一眼文件列表就过了,根本不会细看。
这个测试的第一版,我把索引使用计数伪装成了六周的生产流量。其实都是合成的,几分钟前刚生成的。有一位评审不认可这个前提:循环边界和扫描次数完全对应,而且 9 个索引的 last_idx_scan 时间戳精确到微秒都一模一样。他说得对,后来我重新跑了测试,保证数据来源真实。
后来我换了种方式,把同一张表作为性能评审案例发出去,只说 “写入延迟在上升,VACUUM 一周比一周慢”,不带任何统计数据。四次运行全都发现了问题。它们找出了 6 个都包含 last_activity_at 的索引,得出结论:这张表的任何更新都不可能是 HOT 更新,然后连查询计划都没看就建议删掉索引。而且每个实例在删索引之前,都会先查 pg_stat_user_indexes。给它们统计数据的话,给出的建议会更精准。
“生产级可用” 是一个数据库决策
说回 “make it production-ready” 这句话,模型 B 和 D 的 18 次运行,提示词最后都有这句话。我在兽医和货运场景的需求上,去掉这句话重新跑了这两个模型,提示词就只剩 “读这个文件,写 schema”。
| 条件 | 兽医场景,单表索引数 | 货运场景,单表索引数 |
|---|---|---|
| 模型 B/D,带完整提示词 | 1.77 – 1.93 | 2.33 – 3.14 |
| 仅需求描述 | 1.33 – 1.59(B/D) | 2.17 – 2.46(B) |
| 模型 A,仅需求描述 | 1.05 – 1.06 | 未测试 |
| 模型 C,仅需求描述 | 0.55 | 0.96 |
就这一句话,让索引数量增加了约五分之一。兽医场景多 20%,货运场景多 17%。提示词末尾的三个单词,没人会把这当成一个 schema 决策,却实实在在地影响了应用里最忙的表的写入成本。
这两个数字都不是人为造出来的。带完整提示词的才是人们实际使用时的情况,所以那组数据更贴近现实。纯需求描述的组别,是用来公平对比模型能力的。
模型之间的差异依然存在,只是差距缩小了。纯需求描述下,模型 B/D 和模型 A 的差距从 1.8 倍变成了 1.4 倍。和模型 C 的差距还是很大:兽医场景 2.7 倍,货运场景 2.4 倍。其中约三分之一的差距来自提示词,剩下的就是模型本身的差异。
这个规律在所有 7 张热点表上都成立:兽医场景的表上,非必须的索引数量,模型 B/D 是 16~20 个,模型 A 是 8~10 个,模型 C 是 5 个。
厂商差异并没有决定一切。无论索引密度高低,没有模型会下意识地给外键建索引。冗余度也和索引数量不成正比:冗余索引最多的两次运行,整体索引数只排在中间;而索引最密的那份 schema,163 个索引里只有 1 个是冗余的。
与此同时,最精简的那份货运 schema,在 load_assignments 表上建了 4 个部分唯一索引(全都以 status 为谓词)。这些索引是用来保证数据正确性的,不能删,但它们和可选索引一样,都会破坏 HOT 更新。
关于提示词对比,有两点需要说明:模型 A 的厂商同时也是这里用到的两份需求文档的作者;而模型 C 每个场景只跑了一次。它们读过预注册文件,知道这是个索引实验。重跑是在干净的目录里进行的,用的都是中性名称。
30 份 schema 里有 18 份来自同一家厂商。这个密度是那款模型的特点,不是所有模型的共性:不同模型之间的差异可达三倍,而提示词还会再改变这个数值。但不管是谁写的 schema,写入成本的规律都是一样的。
检查生产环境的写入路径
这些都不是主张 “索引极简主义” 的理由。对于读多写少、没有频繁更新的表,索引几乎是免费的。如果是要在 “跑 40 秒的报表” 和 “给只追加的日志表多加一个索引” 之间选,那肯定加索引。
真正的问题在于,在写入繁重的业务表上,一个接一个地加索引。在我的客服场景测试里,两个索引就支撑了 90% 的查询。与此同时,工单主题上的两个大 GIN 索引占了 130 MB 磁盘,每次插入和修改主题都要维护它们,但在正常工作流测试里,一次扫描都没被用到。
在生产库上,动任何索引之前先查 pg_stat_user_indexes:
SELECT
  s.relname,
  s.indexrelname,
  pg_size_pretty(pg_relation_size(s.indexrelid)) AS size,
  i.indisunique AS uniq,
  s.idx_scan,
  s.last_idx_scan
FROM pg_stat_user_indexes s
JOIN pg_index i ON i.indexrelid = s.indexrelid
WHERE NOT i.indisprimary
  AND s.idx_scan = 0
ORDER BY pg_relation_size(s.indexrelid) DESC;
用 dryrun 工具的用户,可以用 detect kind=unused_indexes 命令,基于 schema 快照离线检查同样的问题,这样可以在变更时就发现,而不是等上线后。底层用的是同样的统计指标,所以注意事项也一样。
删索引之前一定要先看懂输出:统计计数器会在数据库重启时重置;备库可能会用到主库不用的索引;还有些唯一索引是为了数据完整性存在的。
在我的测试里,tickets_subject_fts_idx 显示零扫描,只是因为查询都会先按 workspace_id 过滤(百万行里只命中 500 行),PostgreSQL 就直接跳过了全文检索。一次基准测试里零扫描,不代表就可以删掉这个索引。