由 John Doe 九月 24, 2026
最近 Hacker News 上对于 PlanetScale 最近发布的全文检索功能,围绕技术实现本质、AI 对数据库开发的影响以及开源许可与云服务商业化三大主题展开了深入探讨。
目录
AI/LLM 是推动全文搜索“大爆炸”的原因吗?
观点 A:AI 工具降低了算法实现门槛(AI 赋能论)
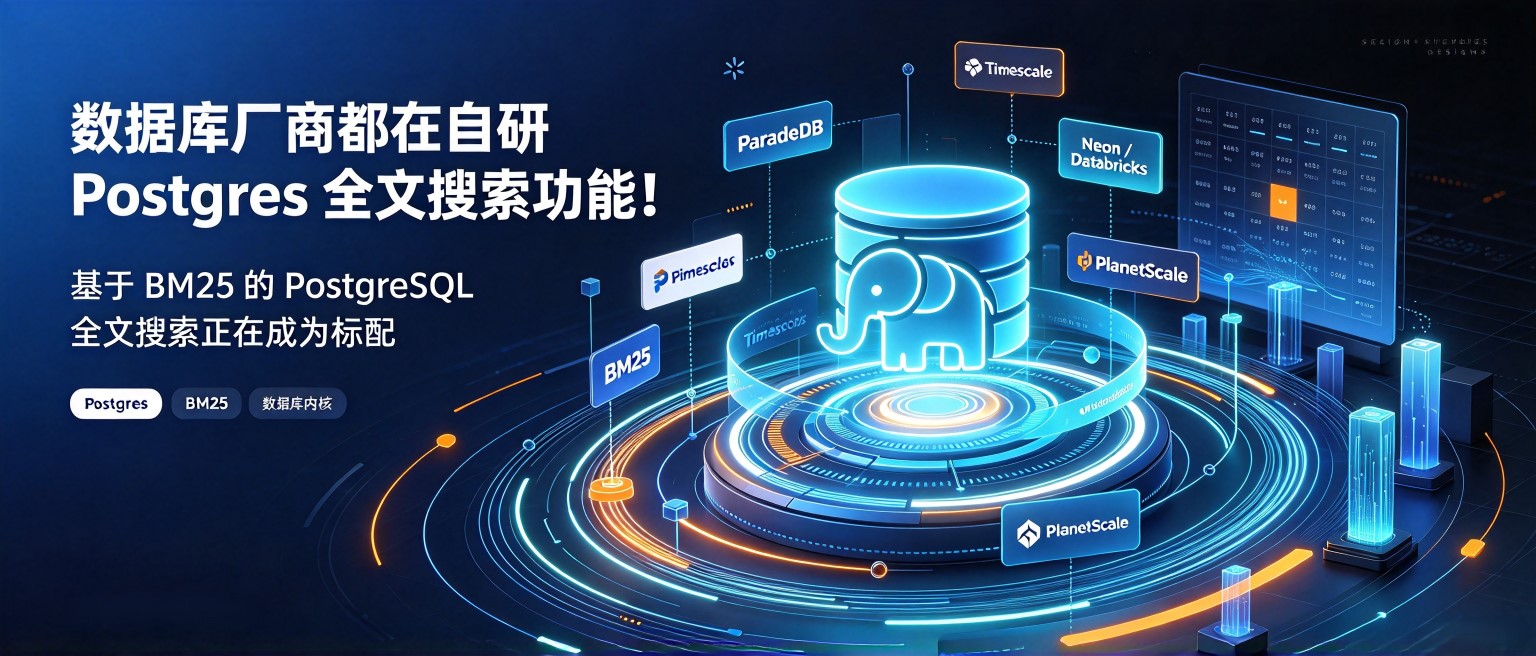
- 评论者指出,近期多家数据库公司(ParadeDB、Timescale、Neon/Databricks、PlanetScale)接连推出了基于 BM25 算法的 PostgreSQL 全文搜索功能。
- 他们认为这是 AI 辅助编程(Agentic / Vibe Coding) 在基础软件领域的体现:开发者只需让 AI 阅读 BM25 算法文档,就能快速在各自的数据库架构中实现该功能,导致此类功能迅速“通货膨胀/商品化”。
观点 B:核心难点在数据库底层,而非 BM25 算法本身(专业壁垒论)
- 资深数据库开发者反驳指出,BM25 算法本身极其简单(数十行代码即可实现)。
- 真正的工程挑战在于 PostgreSQL 底层架构:包括内存/磁盘索引数据结构设计、高并发下的数据段合并、故障容错、批处理与高吞吐写入。
- 这类高性能项目的成功依然取决于“顶级数据库专家 + LLM”的结合,单纯依靠 LLM 生成的代码极易变成不可用的烂摊子。
- ParadeDB 官方开发者 现身说明:ParadeDB (
pg_search) 的研发早于当前大模型热潮,不过他也承认近期社区中确实出现了不少由 AI 驱动(Vibe Coding)的 PostgreSQL 全文搜索项目。
云端独占 vs 开源承诺:商业模式与开源生态的博弈
争议点:云服务商“用开源底座,闭源高性能扩展”
- 评论者指出,PlanetScale 的高性能实现 Tin 仅在他们的托管云服务中提供,开源的本地版本(
planetscale/lead)仅用于语法测试,缺乏高性能特性。 - 部分开发者对此感到不满,认为文章标题《Postgres 的全文搜索》有误导性,本质上是 “PlanetScale 云平台的全文搜索”,容易造成供应商锁定。
辩护点:商业回报驱动开源上游反哺
支持者与 PlanetScale 工程师提出了现实的商业逻辑:
- 投资回报(ROI):许可云端闭源扩展所带来的商业利润,正是吸引企业持续投入资金研发开源软件的根本动力。
- 反哺上游生态:PlanetScale 在研发 Tin 的过程中,为 PostgreSQL 上游官方社区(如 Postgres 18.6)、LLVM 以及
pgrx(Rust 构建 Postgres 扩展的框架)贡献了大量底层修复与性能改进。即使扩展闭源,开源社区也间接享受到了代码升级的好处。
AI 对开源软件许可范式的潜在影响
评论者补充了一个行业视角:在 LLM 时代,大模型未经许可无偿抓取开源代码进行训练,这会导致越来越多的商业公司减少纯开源项目,转向 Open Core(开源核心 + 闭源高级功能) 或 云端独占 模式,以保护自身的商业壁垒。
评论区观点汇总对比
| 讨论维度 | 主流支持观点 | 反驳/补充观点 |
|---|---|---|
| AI 编程作用 | LLM 大幅降低了 BM25 等经典算法在不同数据库上的移植门槛。 | 算法简单,难点在 Postgres 内存/磁盘索引设计与高并发存储引擎,依然高度依赖专家。 |
| 产品可用性 | 提供了开箱即用的高性能 BM25 搜索,大幅简化架构复杂度。 | 本地开源版本仅供测试,核心性能绑在云端,存在供应商锁定隐患。 |
| 开源商业道德 | 商业公司有权对其二次开发闭源,且项目反哺了 Postgres 18.6 等上游代码。 | 利用开源许可的宽松性做云端闭源商业化,给开发者带来“不佳的心理体验”。 |
总结与行业洞察
HN 社区对该帖子的讨论,本质上反映了当前基础软件领域的两个关键趋势:
- 大模型赋能的边界:LLM 正在加速应用层与标准算法的工程落地,但在基础数据库系统的内存管理、磁盘 IO 与高并发架构设计等“深水区”,顶级开发者的行业认知仍是决定性因素。
- 开源基础设施的商业化转向:单纯的纯开源商业模式在日益激烈的云服务竞争与大模型代码抓取背景下难以为继,“开源接口/语法测试 + 云端独占高性能引擎”正逐渐成为基础软件公司的主流变现策略。
参考
Hacker News: Tin: full-text search for Postgres