由 John Doe 十月 12, 2026
在创建 Postgres 数据库实例时,你需要在 aarch64(ARM)与 x86-64 两种架构之间做出选择。两个 vCPU 数量、内存完全相同的集群,若采用不同架构,实际性能可能天差地别。
作者:艾哈迈德・达维奇
并非所有云端 vCPU 都生而平等。理解其中的影响至关重要,因为集群一旦创建,就无法轻易更换 CPU 架构。
ARM 与 x86:生来使命不同
x86 架构诞生于桌面端,核心设计目标是向后兼容性与极致性能。它于 1978 年由英特尔推出,而当年 IBM 决定在初代个人电脑中采用 x86 处理器,也奠定了它在个人电脑领域的统治地位。
开发出首款 ARM 处理器的英国计算机公司 Acorn,初衷是通过采用廉价的塑料芯片封装来压低制造成本。为了防止芯片过热,研发团队将功耗预算设定为 1 瓦。
1985 年 4 月,Acorn 的工程师首次给芯片通电时,芯片正常运行,但电源表的读数却为零。原来是测试板出现故障,芯片根本没接上电源,全靠周边电路泄漏的电流在工作。正式接通电源后,它的功耗仅约 0.1 瓦,远低于 1 瓦的预算。ARM 设计师索菲・威尔逊(Sophie Wilson)后来称,这种高能效完全是个意外之喜。
ARM 的低功耗特性让它完美适配手机设备。而随着数据中心运营商想方设法降低电力与冷却成本,这种能效优势也让它在服务器领域崭露头角。如今 AWS 和谷歌都为云服务器自研了 ARM 处理器:分别是 Graviton 和 Axion。
CPU 架构如何影响 Postgres 性能
对于数据库而言,两者的差异首先体现在云厂商对「vCPU」的定义上。
什么是超线程?
一个 CPU 核心包含多个执行单元,但单一线程往往无法让所有单元都满负荷运转,线程经常会因等待内存数据而陷入停滞。
超线程技术允许一个核心同时加载两个线程。当其中一个线程停滞时,核心可以运行另一个线程的指令。
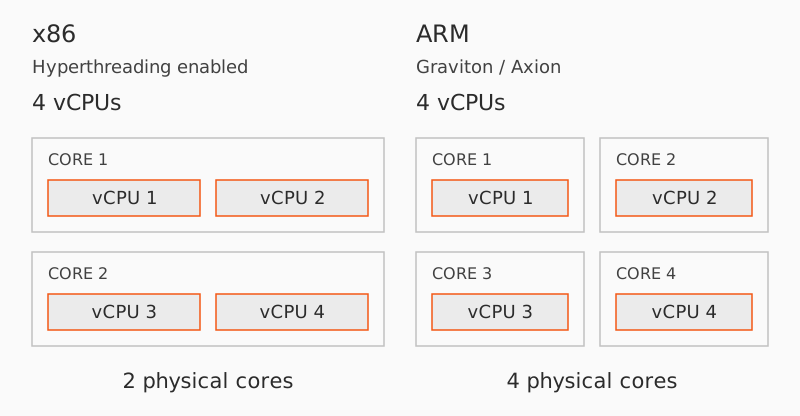
打个比方:就像一间厨房里有两位厨师,他们能产出更多菜品,但需要共用烤箱和水槽。在支持超线程的 x86 实例中,云厂商会把每个线程都当作一个 vCPU 来售卖。
而 AWS Graviton、谷歌 Axion 这类 ARM 服务器芯片不支持超线程。每个 vCPU 都是一个完整的物理核心,各自拥有独立的「烤箱」和「水槽」。
多并发工作负载,还是单条重查询?
这正是 ARM 的优势所在:当大量查询同时涌入时,更多的核心数能提供更好的表现。例如一家线上商店,可能同时要为数百位顾客执行商品查询、库存校验、购物车更新等操作。每条查询的计算量都不大,但数据库可以将它们分散到各个核心上并行处理。
充足的核心也为并行查询工作进程、以及 Postgres 的后台清理进程 autovacuum 留出了运行空间,让它们可以和业务查询同时运行互不干扰。
但换一种场景:比如一个报表仪表盘,单条查询需要花费数秒对数百万条销售记录做汇总计算。如果这条查询是 CPU 密集型且不支持并行工作,那么再多的核心也无法让它运行得更快。此时单核性能就成了关键,而这正是 x86 的传统优势。x86 服务器芯片通常主频更高,核心处理指令的速度更快,因此单核心跑完单条查询的耗时更短。
宽向量寄存器
核心的性能还取决于单条指令能完成多少工作量。有些指令可以一次性处理多个数值。
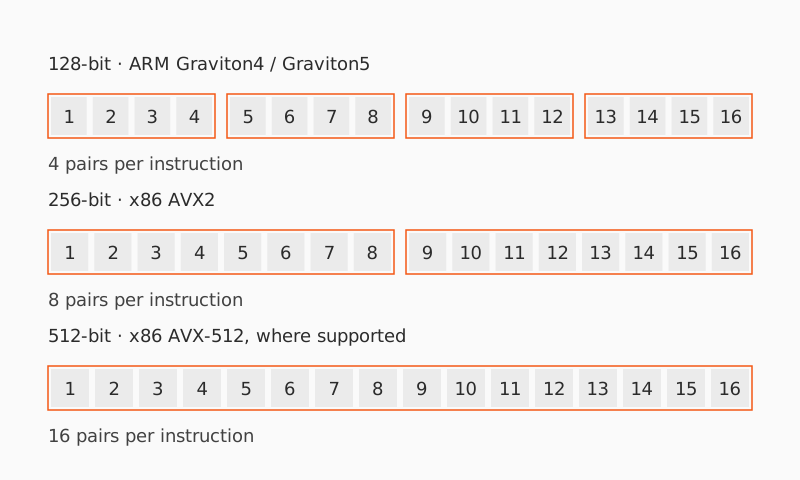
假设你需要对比两组 32 位数字。一条向量指令可以一步完成多组对比:128 位向量能同时对比 4 组,256 位向量能对比 8 组,512 位向量则能对比 16 组。
位宽更大的向量意味着单条指令能处理更多数据,完成同样的工作所需的指令数就更少。
在 x86 架构中,AVX2 是一套支持 256 位向量的向量指令集。部分芯片还支持 AVX-512,将向量位宽拓展至 512 位。而 AWS 的 ARM 服务器芯片 Graviton4、Graviton5 采用的是 128 位向量。
TIN 是 PlanetScale 为 Postgres 打造的全文搜索索引,它就利用向量指令来对比位图。每个页面级位图包含 256 位,每一位记录了对应数据库页面是否包含某个搜索词。
假设有一张 articles 表,其中有一个名为 body 的文本列。我们可以创建 TIN 索引,然后搜索同时包含「postgres」和「replication」的文章:
CREATE INDEX articles_body_tin ON articles USING tin (body);
SELECT * FROM articles WHERE body ==> 'postgres AND replication';
==> 操作符用于执行 TIN 搜索。TIN 会对两个关键词的位图执行交集运算,找出可能同时包含这两个词的页面。在 x86 架构上,它只需一条 AVX2 的 AND 指令就能完成全部 256 位的交集计算。
Postgres 的向量相似度搜索扩展 pgvector,也针对 x86 做了专项优化。它的 AVX-512 代码可用于计算汉明距离和杰卡德距离,这两种指标用于衡量两个位向量的差异程度或重叠度。而在 ARM 架构上,这些计算只能使用通用代码实现。因此对于某些索引类型,x86 有着显著的性能优势。
为什么现有集群无法更换架构
Postgres 本身可以在两种架构上运行,但它写入磁盘的文件在不同架构之间并不通用。
迁移 Postgres 数据库到新硬件的常规方式,是在新硬件上搭建副本,再将副本提升为主库。但这种方式无法跨架构实现,这与副本的构建机制有关。
副本并不会从零重建数据库,而是先逐字节复制主库磁盘上的所有文件,包括数据表和索引,然后通过重放预写日志(WAL,即记录所有数据变更的运行日志)来保持数据同步。两台机器对这些文件的解析方式存在差异,可能会导致错误的结果。
Postgres 用于快速文本匹配和相似度搜索的扩展 pg_trgm,就很好地体现了这种问题的隐蔽性。它在设计之初并未考虑索引跨架构迁移的场景。
Postgres 由 C 语言编写,而 C 语言中,编译器会决定普通 char 类型是有符号还是无符号。GCC 和 Clang 是两款主流 C 编译器,在 x86-64 Linux 上默认 char 为有符号型,而在 ARM64 Linux 上则默认为无符号型。因此同一个字节值 0xFF,在一种架构上代表 -1,在另一种上则代表 255。
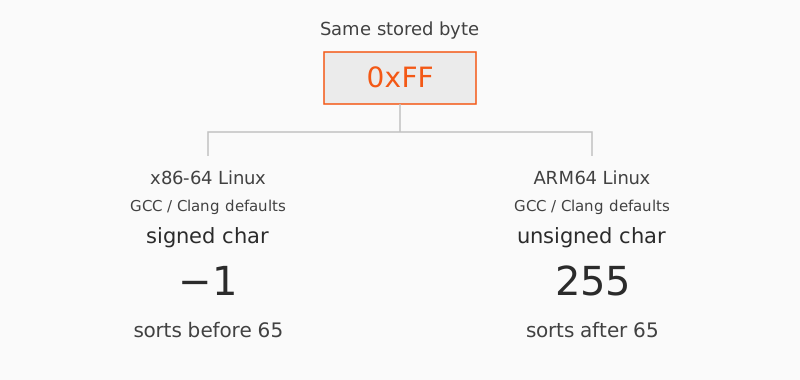
pg_trgm 在索引内部对三元组(三个字符的组合)排序时,依赖 char 类型的比较运算。如果把索引直接复制到另一种架构上,新机器对排序规则的判断就会出现不一致。
Postgres 在 18 版本中修复了这个问题。但它很好地说明了核心问题:单纯复制字节数据,无法保证两台机器对数据的解读完全一致。
PlanetScale 要求主库与其所有副本都运行在相同的 CPU 架构上。在 Neki 中,架构信息固定在分片所使用的配置文件中。
这些限制不影响日常运维操作。集群扩容、添加副本等操作都会保持原有架构不变,因此可以正常执行。
如果你确实需要切换架构,就必须迁移到一个新的集群。你需要在新集群中创建表和索引,然后通过逻辑复制来同步数据并追平写入。目标集群会基于这些数据自行构建索引条目,因此排序规则会完全匹配自身的比较规则。
该如何选择?
对于普通读写负载的全新应用,创建集群时优先选择 ARM 架构不会错。它拥有出色的性价比,并且能很好地应对并发场景。在 PlanetScale 平台上,相同 vCPU 和内存规格下,ARM 实例通常比 x86 更便宜,不过具体价格会随规格和区域有所不同,详情可查看定价页面。
如果你的工作负载中,少数几条 CPU 密集型查询占据了绝大部分计算资源,那么可以重点考虑 x86 架构。
如果性能对你的业务至关重要,想要选出最适合自身负载的架构,最好的方式是在正式部署前,分别在 ARM 和 x86 集群上运行实际业务进行测试。保持数据和配置完全一致,按照业务高峰期的并发量进行压测,对比两者的吞吐量、慢查询响应时间以及成本。
将已有的 PlanetScale 数据库迁移到另一种架构需要做数据迁移,因此请务必确认性能或成本上的提升值得这份投入。
参考
PlanetScale: When to choose x86-64 vs aarch64