由 John Doe 十月 28, 2026
PostgreSQL 正在渐渐变成一个应用开发平台,后端工程师也需要逐渐适应这种变化。
目录
作者:Anurag Goel
大多数后端工程师终其职业生涯都不会换掉 PostgreSQL,真正需要迭代升级的,是他们使用 PostgreSQL 的方式。
在运维着数亿行数据的生产系统多年后,我发现绝大多数 PostgreSQL 性能问题,靠堆 CPU、加内存是解决不了的。真正的解法,是理解 PostgreSQL 的运行逻辑。
以下是经过我反复验证、切实有效的技术技巧,也是我希望入行第一天就能有人交给我的经验清单。
后端工程师的 25 个 PostgreSQL 实用技巧
1. 摒弃 SELECT * 写法
这是整张清单里成本最低、见效最快的性能优化。
反面写法:
SELECT * FROM users WHERE id = 123;
推荐写法:
SELECT name, email FROM users WHERE id = 123;
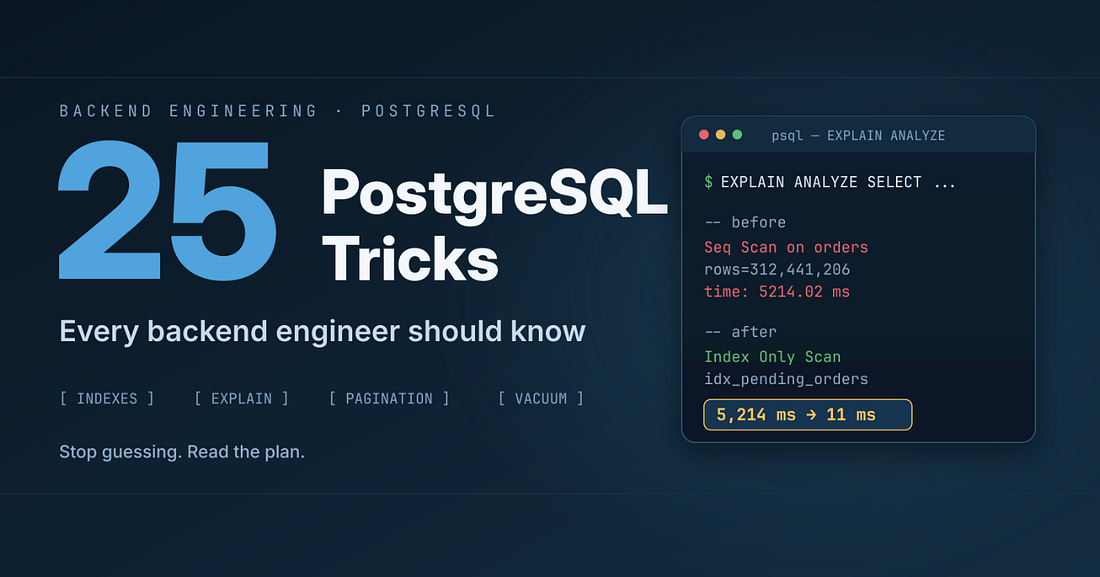
每多查一列,都会迫使 PostgreSQL 读取更多数据页、搬运更多数据、在网络中传输更多字节。更严重的是,SELECT * 往往会让数据库无法走索引仅扫描(Index Only Scan),而这是查询优化器可用的最快访问路径之一。
2. 养成默认使用 EXPLAIN 的习惯
永远不要凭直觉调优查询。执行:
EXPLAIN ANALYZE
然后认真读懂输出结果。重点关注:顺序扫描(Sequential Scans)、嵌套循环连接(Nested Loops)、哈希连接(Hash Joins)、位图堆扫描(Bitmap Heap Scans)、「过滤移除行数(Rows Removed by Filter)」以及缓冲区计数。
十有八九,执行计划已经明确告诉了你时间都耗在了哪里,你只需要读懂它。
3. 索引并非免费午餐
有一种常见误区:索引越多,数据库越快。
事实并非如此。
索引会加速读操作,但每一次插入、更新、删除都需要同步维护所有索引。一个从未被使用的索引,只有纯纯的写入开销,没有任何收益。
新增索引前,先问自己一个核心问题:真的有查询会用到它吗?(也可以通过 pg_stat_user_indexes 检查现有索引是否真的在发挥作用。)
4. 联合索引的列顺序绝非无关紧要
如果你的查询条件是:
WHERE org_id = ? AND status = ?
那么索引应该建为:(org_id, status),而非:(status, org_id)
除非你的绝大多数查询都只按 status 单独过滤。最左侧的列决定了这个索引能否被使用。这个细节坑到的工程师,比清单里其他任何知识点都多。
5. 部分索引值得被更多人使用
与其给全表建索引:
CREATE INDEX idx_orders_status ON orders(status);
不如只给你真正会查询的行建索引:
CREATE INDEX idx_pending_orders ON orders(created_at) WHERE status = 'PENDING';
如果待处理订单只占总量的 2%,那这个索引的体积也只有全量索引的 2%,体积更小、维护成本更低、遍历速度更快。这项特性被严重低估了。
6. 覆盖索引:完全跳过表访问
有时候最快的表访问,就是不访问表:
CREATE INDEX idx_user_email ON users(email) INCLUDE (name);
只需要 email 和 name 的查询,完全可以直接从索引中返回结果,根本不需要访问堆表。
7. 键集分页永远优于 OFFSET 分页
下面这种写法,分页越靠后性能越差:
LIMIT 20 OFFSET 500000
PostgreSQL 仍然需要遍历跳过这 50 万行数据。改用「上一条记录的游标值」来分页:
WHERE id > :last_seen_id ORDER BY id LIMIT 20
第一页和第五万页,查询成本几乎完全一致。
8. 随机 UUID 会悄悄毁掉你的索引
UUIDv4 主键会随机散落在索引的各个位置,在写密集的表上会造成索引碎片,严重破坏缓存局部性。
如果你需要全局唯一 ID,优先选择时序有序的方案,比如 UUIDv7、ULID 或 KSUID。它们会像自增 ID 一样,把新数据追加在索引的「热端」。
9. JSONB 是利器,而非表结构的替代品
JSONB 在灵活元数据、用户偏好、功能开关这类真正无固定结构的场景里表现出色。
但它不是你不用设计关系表的借口。
如果你发现自己需要频繁按 JSONB 字段做过滤,就加上对应的 GIN 索引。并且一定要做基准测试,JSONB 的查询性能经常会出人意料(好坏都有可能)。
10. 重视 VACUUM 机制
MVCC(多版本并发控制)机制意味着,每一次更新和删除都会留下死元组。长期不做清理,你会面对索引膨胀、表持续变大、查询性能莫名下降的问题。
自动清理(Autovacuum)能处理大部分场景。而监控自动清理的运行状态、及时发现它跟不上写入速度的时刻,决定了你的值班是平稳度过还是焦头烂额。
11. 做好连接池管理
PostgreSQL 的连接成本很高,每个连接对应一个独立进程。同时打开上千个连接,数据库的精力都会耗在连接管理上,而非执行查询。
在数据库前面加上 PgBouncer、RDS Proxy,或是使用 pgxpool 这类客户端连接池。这是你能做的投入产出比最高的基础设施优化之一。
12. 批量执行插入操作
一万条单条 INSERT 语句,意味着一万次网络往返。
把它们合并成多行插入:
INSERT INTO events (a, b) VALUES (...), (...), (...);
或者直接使用 COPY 命令。性能差距不是一点点,通常能达到一个数量级甚至更高。
13. COPY 是批量导入的王者
当你需要导入海量数据时,没有任何方案能和 COPY 相提并论。普通插入需要几小时才能跑完的数百万行数据,用 COPY 只需要几分钟。
14. 表分区并不可怕
当表足够大之后,按租户、按月、按年做表分区会带来实实在在的收益:运维成本更低、批量删除更快(直接删除分区而非逐行删除)、单次查询扫描的数据量更少。
不要过早使用分区,但也不必畏惧它。
15. 有时顺序扫描才是最优解
开发者一看到执行计划里出现顺序扫描就会慌。
但如果 PostgreSQL 预判本来就要读取表中大部分数据,顺序遍历表反而比通过索引逐行跳转更快。优化器通常是懂这个道理的。
先信任它,直到基准测试证明它错了。
16. 排查并消灭 N+1 查询
十个各自很快的查询加起来,通常也跑不赢一条写得好的单查询。光是网络往返的开销就足以拖垮性能。
JOIN、CTE 和窗口函数的存在,正是为了让你不用在应用代码里循环执行查询。
17. 让窗口函数替你完成计算
排名、去重、累计求和、相邻行对比,别再在应用代码里做这些事了。
ROW_NUMBER()、RANK()、LAG() / LEAD()、SUM() OVER (...)
PostgreSQL 紧贴数据完成这些运算,通常比任何应用层循环都更快,代码也更简洁。
18. 理解 CTE 的物化机制
在旧版本 PostgreSQL 中,每一个 CTE 都会被完整物化,全部计算完、存起来,再被外层读取。现代版本(12 及以上)通常会把 CTE 内联到主查询中,你也可以通过 MATERIALIZED / NOT MATERIALIZED 强制指定行为。
这个不起眼的细节,能让查询性能发生天翻地覆的变化。你要清楚自己的数据库实际在按哪种逻辑执行。
19. 统计信息过期会生成糟糕的执行计划
当 PostgreSQL 选出了一个匪夷所思的执行计划,问题往往不在查询本身,而在于数据分布的统计信息已经过时。
数据发生大规模变更后,执行:
ANALYZE;
统计信息更新了,执行计划也就正常了。
20. 开启 pg_stat_statements 扩展
看不见的问题,你永远没法修复。这个扩展会追踪你全量工作负载里,每种查询的总耗时、调用次数、平均延迟。
真正拖垮数据库的查询,很少是你能猜到的那几个。pg_stat_statements 会给你一份精准的排名清单,替代盲目猜测。
21. 任务队列场景使用 FOR UPDATE SKIP LOCKED
用 PostgreSQL 构建工作队列?这个语法就是核心秘诀:
SELECT * FROM jobs WHERE status = 'PENDING'
ORDER BY created_at
FOR UPDATE SKIP LOCKED
LIMIT 10;
多个工作进程可以并发拉取任务,不会互相阻塞,也不会抢到同一行数据。很多完整的消息队列部署,都可以用这一个模式替代。
22. 选择稳妥且正确的数据类型
不起眼的小选择,会累积出巨大的影响:
- 永远用
timestamptz而非timestamp,无时区时间戳早晚会引发线上时区 bug。 - 用
text而非varchar(n),在 PostgreSQL 里长度限制没有实际收益,后续还会添麻烦。 - 计数类字段用
bigint,自增列溢出的那天,会是一场大灾难。 - 金额用精确数值类型,绝对别用浮点数。
23. 提前设置超时阈值
一条失控的查询、一个忘记提交的事务,就足以拖垮整个应用。提前做好防护:
SET statement_timeout = '30s';
SET lock_timeout = '5s';
SET idle_in_transaction_session_timeout = '60s';
这三个配置避免的生产事故,比很多监控仪表盘都多。
24. 学会使用 LATERAL 连接
「每组取前 N 条」的场景,比如 “每个客户的最新订单、每个作者热度前三的文章”,正是 LATERAL 的用武之地:
SELECT c.name, o.*
FROM customers c
CROSS JOIN LATERAL (
  SELECT * FROM orders
  WHERE customer_id = c.id
  ORDER BY created_at DESC
  LIMIT 3
) o;
你可以把它理解成能返回多行多列的关联子查询。一旦搞懂了,你会发现处处都能用。
25. 先测量,再改动,再复测
直觉会骗人,基准测试不会。
清单里的每一项优化,都该用同一种方式验证:用 EXPLAIN ANALYZE 记录执行计划和耗时,做一项改动,再重新测量。没经过测量的不叫优化,只是改了代码而已。
我最推崇的一条准则
总有人问我:「PostgreSQL 最有效的优化手段是什么?」
不是索引,不是分区,更不是升级硬件。
是读懂执行计划,理解 PostgreSQL 为什么会选择这个方案。
当执行计划不再像天书,数据库调优就不再是玄学,而是实打实的工程工作。
写在最后
PostgreSQL 已经悄然成长为最强大的数据库之一。很多团队用它承载数亿甚至数十亿行数据,全程无需更换数据库。
一套运行缓慢的 PostgreSQL 和一套高性能的 PostgreSQL,差距往往不在硬件,通常也不在表结构,而在于是否清楚哪些优化真正有效、能否客观衡量优化效果、以及能否克制住过早引入复杂度的冲动。
吃透这些基础技巧,PostgreSQL 能支撑你走得比大多数人想象的远得多。