由 John Doe 十一月 5, 2026
在 2026 年的 IT 行业,PostgreSQL 等开源数据库大行其道的今天,还有人在用 Oracle 吗?
目录
作者:Oz
上周我发表了针对数据库架构的批评文章,这不只是推开了一扇门,更是捅了马蜂窝。一半的社区读者为之叫好,称终于有人戳破了 “皇帝的新衣”;而另一半(那些 90 年代企业级时代的老兵们)则指责我离经叛道。他们声称,比起甲骨文的铜墙铁壁,PostgreSQL 不过是个玩具。
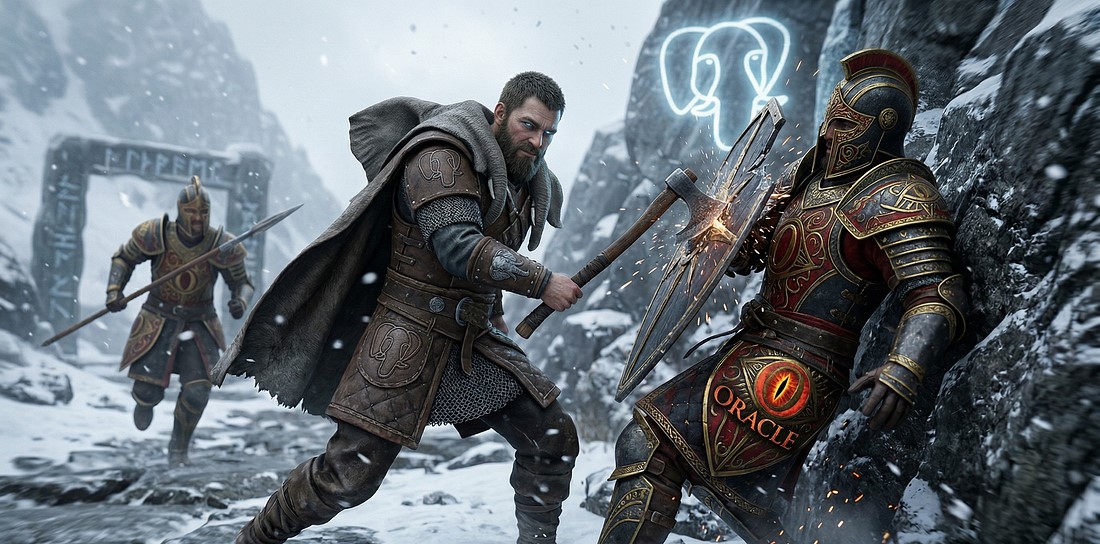
过去 72 小时里,我读完了每一条尖酸的评论与每一份技术反驳。而今天,我要更进一步,直白地表明立场:我不只是在预言甲骨文的衰落,更是在宣告它的终局。数据中心核心话语权的争夺战已经落幕。PostgreSQL 不只是参与了竞争,当这位红木巨人还在忙着核查授权审计时,它早已重写了游戏规则。
企业级安全网的神话
三十年来,甲骨文靠一种强大的情绪长盛不衰:恐惧。CIO 们采购甲骨文,是因为他们被告知,没有它,自己的数据就会烟消云散。曾几何时,CIO 里的 “I” 代表的是 “保险(Insurance)”。你缴纳 “甲骨文税”,买的不是代码,而是法律层面的免责保障。
但坦诚说,放眼当下的现实,甲骨文早已不是一家数据库公司,它是一家顺便搭载了关系型数据库引擎的律师事务所。它最伟大的创新从来不是关系引擎或恢复管理器,而是那份让用户再也无法脱身的严苛合同。
我们曾被灌输:企业级就意味着昂贵、专有、复杂。但到了 2026 年,这个定义已经转向了透明性与可移植性。我曾和一位财富 500 强公司的首席工程师聊过,他的总结一针见血:遇到 PostgreSQL 的性能瓶颈,他可以通过阅读源码、参考社区成千上万的补丁来解决;可要是甲骨文出了问题,他只能像个人质一样,等着 “谈判专家” 回电。
这就是权力格局的根本转变。真正的安全,不是用血签下的支持合同,而是理解、分叉、修改你所依赖工具的能力。选择甲骨文,你买到的是一个黑盒;选择 PostgreSQL,你拥有的是全球的智慧储备。
创新悖论:扩展能力 vs 单体巨物
我收到最多的嘲讽,是说 PostgreSQL 架构老旧。他们叫嚣着,这是一套有着 35 年历史的基于进程的系统。对此我的回答是:没错,正因如此。PostgreSQL 的精髓并不在其内核,而在于它的可扩展性。PostgreSQL 早已不只是一个数据库,它是构建专用数据引擎的框架。当甲骨文试图靠私有钩子不断膨胀内核二进制文件,讨好所有用户时,PostgreSQL 已经成长为一个平台。
看看 2020 年代中期的 AI 革命就知道了。当甲骨文忙着发布光鲜的新闻稿和营销手册,鼓吹自己的遗留系统 “适配 AI” 时,PostgreSQL 社区直接拿出了 pgvector。他们不用等董事会决议,不用等季度发布周期,只因市场有需求,就动手做了出来。当甲骨文把 JSON 支持做得复杂无比,只为抬高定价时,PostgreSQL 已经把 JSONB 打磨到极致,成为了全球最灵活的文档 - 关系混合数据库。
我们不再需要单一厂商提供的 “万能数据库”。我们需要的是一个稳定、开源的内核,能让我们以光速进行定制修改。开源的胜利,从来不是因为 “免费”,而是因为它是一场对话;而专有软件,只是一场独白。等甲骨文的销售走完功能试用的审批流程,现代开发者已经在边缘节点拉起了一个 PostgreSQL 实例,对接了向量存储,部署到了十个区域。在 2026 年,迭代速度才是唯一的硬通货。
硬件壁垒与复杂性的消亡
曾几何时,甲骨文的真正应用集群(RAC)是支撑大规模工作负载的唯一扩容方案。但硬件的演进速度,早已超过了甲骨文的商业模式迭代速度。如今我们身处的时代,NVMe 硬盘能承载百万级 IOPS,服务器的内存容量比过去整个数据中心的磁盘空间还大。一位前辈曾告诉我:过去我们用复杂的专有软件解决架构问题,是因为硬件是瓶颈;但如今,软件本身的复杂性,才是首要的故障点。
纯粹主义者辩称,PostgreSQL 在 10TB 数据量或 10 万连接数下就会触顶。但我的回答很简单:是你用错了方式。如果把一套 35 年历史的架构用默认配置扔到多区域、AI 原生的工作负载场景里,你必然会撞墙。但解决办法不是退回到专有孤岛,而是升级周边的技术栈。
借助 Citus 做分库分表、Supavisor 做连接池、Neon 做无服务器扩容,这道壁垒已经被推得极远,99.9% 的企业甚至永远都碰不到它。纵向扩容本质上是在和光速赛跑,无论你给红木海岸(甲骨文总部所在地)砸多少钱,最终都会栽在 CPU 缓存失效上。甲骨文为硬件稀缺的时代建造了一座大教堂,而 PostgreSQL 为硬件商品化的时代搭建了一座集市。
开源的经济必然性
我们从 CFO 的视角聊聊 “甲骨文税”。在高利率环境下,效率是唯一的核心指标,按核心数收取数据库授权费的模式,在架构层面简直是疯了。2026 年,技术栈里最昂贵的部分不该是软件授权,而应该是打造产品的人才。每给甲骨文送去一百万美元,就是从你的研发预算里偷走一百万美元。
反驳我的老兵们声称,PostgreSQL 的管理成本更高。但我完全不认同。只会调优黑盒的专属 DBA 正在被淘汰。如今的工程师都是全栈能力,熟悉开源体系的语言。随着行业向边缘计算、AI 原生工作负载演进,核心需求不再是严苛的合同,而是极致的敏捷性。
世界上最贵的软件,不是授权费最高的那一个,而是拖慢你工程师脚步、让你赶不上竞争对手的那一个。甲骨文是镀金的船锚,拖住企业转型的脚步;PostgreSQL 是奔涌的河流,能绕过一切阻碍。
PostgreSQL 的困境:自我修正
我不是说 PostgreSQL 完美无缺。我亲眼见过它在实战中捉襟见肘:事务 ID 回卷拖垮过大型系统,表膨胀问题让 DBA 们焦头烂额。如果全程用默认配置,PostgreSQL 在真实负载下会不堪重负。
但核心区别在于:当 PostgreSQL 出问题时,解决方案散落在成千上万篇博客、GitHub Issue 和 Discord 社群里。我宁愿调试一个能看透内部的开源引擎,也不愿为一个不许打开的黑盒付费。
问题从来不出在 PostgreSQL 本身,而出在我们的架构思路。我们花了很多年试图让 PostgreSQL 模仿甲骨文,却本该去让应用更具韧性,让数据层更模块化。我们不需要一个无所不能的 “神级” 数据库,我们需要一个可靠、可预测的 “服务型” 数据库。能让我们夜里安睡的数据库,是我们清楚知道垃圾清理(vacuum)如何工作、预写日志(WAL)如何运行、业务增长时该如何扩容的数据库。
遗留陷阱:为何他们无法转型
为什么甲骨文不能变成 PostgreSQL 那样?因为它的商业模式不允许。它被自己的成功困住了。成千上万的客户被锁定在遗留合同里,每年贡献数十亿美元的维护费。转向真正开放、模块化、对开发者友好的模式,无异于蚕食自己的营收。它就像一头鲨鱼,只能朝着同一个方向不停游,停下就会死。
而 PostgreSQL 是一头 “无头巨兽”。它没有 CEO 要讨好,没有季度财报要达标,没有股价要维护。它只需要做到 “有用” 就够了。这种去中心化的权力结构,正是它胜出的根源。它成为了数据领域的通用语言,因为它是唯一能让所有人达成共识的选择。它就是数据库世界的 Linux。正如 Windows 和 Unix 在服务器战场输给了开源内核,专有数据库也正在数据战争中输给开源引擎。
最终裁决:灯火熄灭时
甲骨文赢下了 20 世纪,因为它为一个权力集中、资源稀缺的时代筑起了堡垒。但在 2026 年,分布式、开源、敏捷开发已是行业常态,人们不再愿意朝拜国王的殿堂。王者的陨落,并非因为某一场战役的失败,而是因为它和当下的构建方式彻底脱节,变得无关紧要。
未来三十年里,甲骨文还会盘踞在全球银行与政府机构的地下室里,作为一个逝去时代的骨架苟延残喘。但未来呢?未来正由一头蓝色大象托举着前行。
争论已经落幕:PostgreSQL 选择成为社区,而甲骨文选择成为孤岛。在技术史上,社区永远、永远比堡垒走得更远。
我们构建系统的目标,早已不只是追求高可用。我们追求迭代速度,适配 AI 时代,打造一个和代码一样灵活的数据层。在这场竞速里,甲骨文不过是一段记忆,一个我们曾以为创新需要 “许可” 的旧时代的残影。如今这张许可早已被撕得粉碎。大象已然登场,并且绝不会退场。
“处处都用 PostgreSQL” 的思路,究竟是危险的技术单一化,还是数据存储的终极形态?如果你觉得我说错了,别拿 2008 年的手册当论据,拿出真实的遥测数据,告诉我有哪种现代工作负载是 PostgreSQL 扛不住的。如果你还在为那座堡垒辩护,不妨问问自己:你捍卫的是技术本身,还是自己付出的沉没成本?欢迎在评论区讨论。