由 John Doe 十月 26, 2026
数据库行业,事务实时处理型数据,和海量分析型数据的融合,一直都是经久不衰的命题。
目录
作者:Kanishk Singh
只要你搭建过不止一两条数据流水线,肯定都遇到过这种经典场景:订单数据存放在 PostgreSQL 中,但三年的历史数据全保留在库里成本太高,于是你把它们以 Parquet 或 Iceberg 格式迁移到了 S3。业务部门想要一个能同时展示两类数据的统一看板,于是你写了个 ETL 任务,设好定时调度,还得把手机放在枕边,等着凌晨两点任务崩掉时的告警通知。
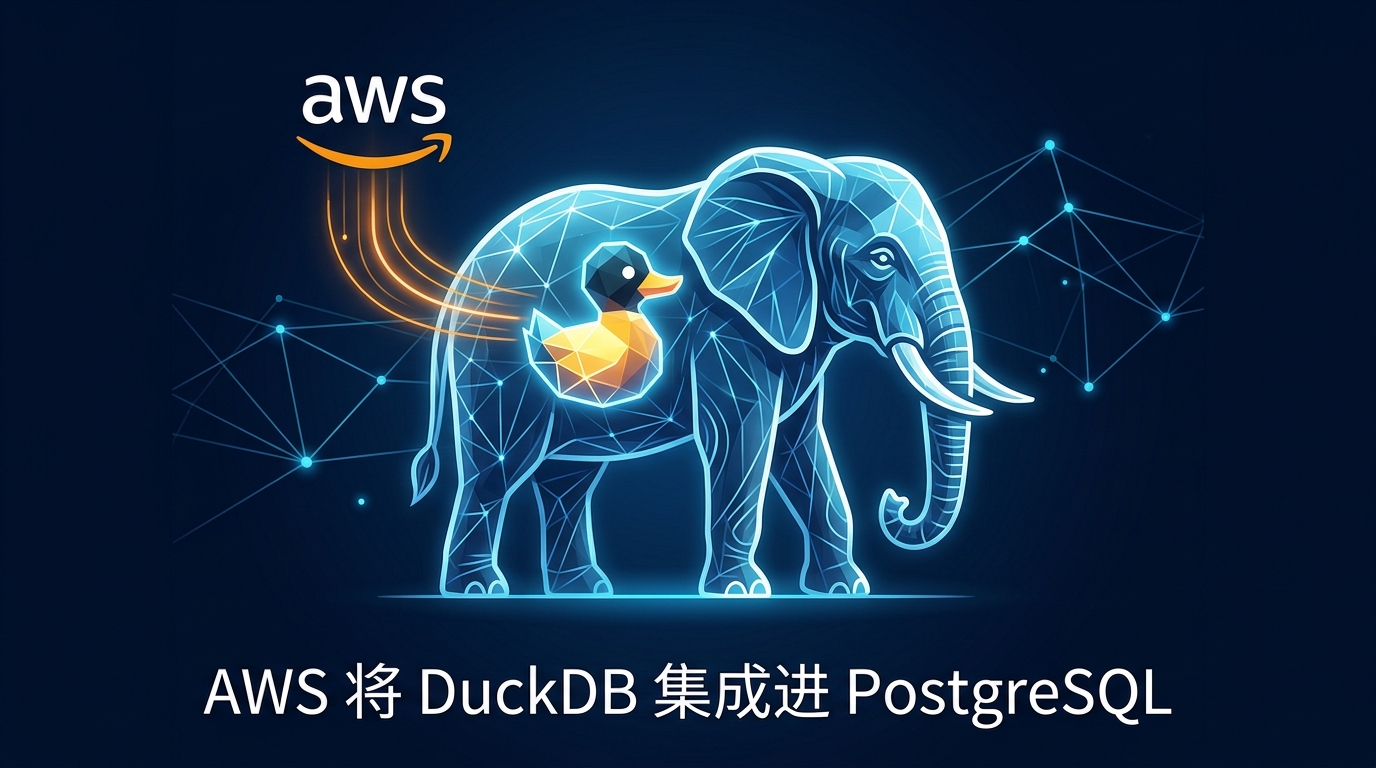
AWS 直接在 Aurora PostgreSQL 中内置了基于 DuckDB 的查询引擎,对很多团队来说,这类 ETL 任务从此不再必要。先说明一个背景:DuckDB 的开发团队 DuckLabs 已于 2025 年加入 AWS,正是这一布局让这项功能得以落地,如今 AWS 已完全拥有这款被集成的引擎。接下来我们说说这项功能对你日常工作的实际影响。
你一直在维护的这套数据流水线
PostgreSQL(交易型 OLTP)        S3(分析型 OLAP)
近90天订单数据          3年历史数据,Parquet / Iceberg 格式
         │                   │
         │       夜间 ETL 任务      │
         └───────────► 数据拷贝 ◄───────────┘
                          │
                      统一数仓表
                          │
                       数据看板
两套独立的系统,靠一个定时拷贝任务打通;只要表结构发生变更,或者任务运行超时,整个链路就会出故障。
带来的改变
你只需要启用一个扩展(AWS 将其命名为 aurora_analytics),创建一个指向 S3 路径的外部表,就能用普通 SQL 同时查询两边的数据,中间不需要任何数据拷贝步骤。
-- one-time setup
CREATE EXTENSION aurora_analytics;

-- point at the Parquet files already sitting in S3
CREATE FOREIGN TABLE orders_history ()
SERVER s3_analytics
OPTIONS (files 's3://my-bucket/orders/*.parquet');

-- Aurora reads the Parquet metadata and infers the columns for you -
-- you don't hand-type a schema

SELECT o.customer_id, o.amount, o.created_at
FROM orders o                 -- live table in Postgres
UNION ALL
SELECT h.customer_id, h.amount, h.created_at
FROM orders_history h         -- foreign table backed by S3
WHERE h.created_at > now() - interval '3 years';
PostgreSQL(交易型 OLTP)        S3(分析型 OLAP)
实时订单数据          历史数据,Parquet / Iceberg / Glue 元数据目录
         │                   │
         └────────── 单条 SQL 查询 ──────────┘
                          │
                       数据看板
没有数据拷贝,没有定时调度,这部分工作再也不会让你凌晨两点被告警叫醒。
这就是它的核心架构原理:Aurora 将查询中的分析部分下推到内置的 DuckDB 引擎执行,DuckDB 正是为这类大扫描量的列式存储计算而生;而 PostgreSQL 继续负责处理实时行数据,发挥它自身的优势。
支持读取的数据源
- 存放在 S3 中的 Parquet 文件
- S3 或 S3 Tables 中的 Iceberg 表
- 在 AWS Glue 数据目录中注册的 Iceberg 表
局限性与成本说明
在你拆掉现有的 ETL 任务之前,有四点需要了解:
- 只读限制:该功能仅支持读取,无法回写 Iceberg。如果需要持久化查询结果,可以通过
CREATE TABLE AS SELECT、INSERT INTO ... SELECT或MERGE语句,将结果写入普通的 Aurora 表中。 - 版本门槛:需要 Aurora PostgreSQL 17.11 或 18.6 及以上版本,更低版本的集群不支持该功能。
- 功能本身免费,但会产生计算成本:扩展本身不收取额外费用,你只需支付 Aurora 的计算费用和 S3 的请求费用。但重型分析查询仍然运行在你的数据库实例上,如果一个看板每次刷新都要扫描三年的历史数据,你的 Aurora 账单会明显上涨,需要留意。
- 仍是单引擎承担两类负载:它只是省去了数据流水线,并没有分离查询调度。如果不注意控制扫描范围,写得不好的分析查询仍然可能挤占 OLTP 业务的资源。
你可以写一个简单的 Go 语言健康检查脚本,放到定时任务或就绪探针里,就能把成本量化:它会区分低成本的 OLTP 查询和高成本的跨源扫描查询,并记录各自的耗时,这样就能在慢查询拖垮事务延迟之前及时发现问题。
package main

import (
 "context"
 "database/sql"
 "log"
 "time"
 _ "github.com/lib/pq"
)

// checkQuery times a single query and flags it if it crosses a threshold.
// Point this at your foreign-table queries after rollout - it's the
// cheapest way to catch a scan that's quietly getting expensive.
func checkQuery(ctx context.Context, db *sql.DB, label, query string, warnAfter time.Duration) {
 start := time.Now()
 rows, err := db.QueryContext(ctx, query)
 if err != nil {
  log.Printf("[%s] query failed: %v", label, err)
  return
 }
 defer rows.Close()
 count := 0
 for rows.Next() {
  count++
 }
 elapsed := time.Since(start)
 status := "ok"
 if elapsed > warnAfter {
  status = "SLOW"
 }
 log.Printf("[%s] rows=%d elapsed=%s status=%s", label, count, elapsed, status)
}

func main() {
 db, err := sql.Open("postgres", "postgres://user:pass@aurora-host:5432/mydb?sslmode=require")
 if err != nil {
  log.Fatal(err)
 }
 defer db.Close()
 ctx, cancel := context.WithTimeout(context.Background(), 30*time.Second)
 defer cancel()
 // cheap: hits the live OLTP table, indexed lookup
 checkQuery(ctx, db, "live_orders",
  `SELECT id FROM orders WHERE customer_id = 42 LIMIT 10`,
  200*time.Millisecond)
 // potentially expensive: scans the S3-backed foreign table
 checkQuery(ctx, db, "history_scan",
  `SELECT count(*) FROM orders_history WHERE created_at > now() - interval '1 year'`,
  2*time.Second)
}
这段代码没有什么巧妙的技巧,就是数据工程师在启用这类功能后,第一周会实际写的脚本:用来排查哪些看板在悄无声息地消耗成本。
功能背后的核心概念,比功能本身更长久
AWS 的这项功能是新的,但它依托的底层概念早已存在。这些才是值得你深入学习、而非一扫而过的内容:
-
OLTP 与 OLAP 的差异 PostgreSQL 是为大量单行的小读写场景优化的,而 DuckDB 是为扫描百万行数据、返回聚合结果的场景设计的。这项功能之所以成立,正是因为它把不同类型的查询路由到了最适合的引擎上。
-
行式存储与列式存储 PostgreSQL 在磁盘上按行存储数据,适合“查询某一条订单”这类场景;Parquet 按列存储数据,适合“对某字段做三年数据求和”这类场景。这也是为什么 S3 端用 Parquet/Iceberg,而不是再多建几张 PostgreSQL 表。
-
谓词下推与列裁剪 写得好的查询只会从 S3 拉取实际需要的列和行范围,而不是把整个文件都拉过来再过滤。这也是实际场景中控制成本的最核心手段。
-
Iceberg 这类开放表格式 Iceberg 在普通 Parquet 的基础上增加了 Schema 演进、快照、时间旅行等能力,这也是为什么在 AWS、Snowflake、Databricks 等平台的湖仓功能中,它都会成为首选格式。
如果你已经吃透了这四个概念,那理解这项新功能只需要两分钟,你会发现它不过是给同一套底层原理换了个新外壳。如果你还没完全掌握,这刚好是个学习的好契机,因为这些概念的生命力,远比 AWS 这一项具体功能要长久得多。
工具总在不断融合,但它们背后的核心概念,却不会那么频繁地改变。
参考
AWS Just Put DuckDB Inside PostgreSQL. Data Engineers Have Some Rethinking to Do.